
Transformers documentation
Ernie 4.5 Moe
Este modelo foi contribuído para o Hugging Face Transformers em 21/07/2025.


Ernie 4.5 Moe
Visão geral
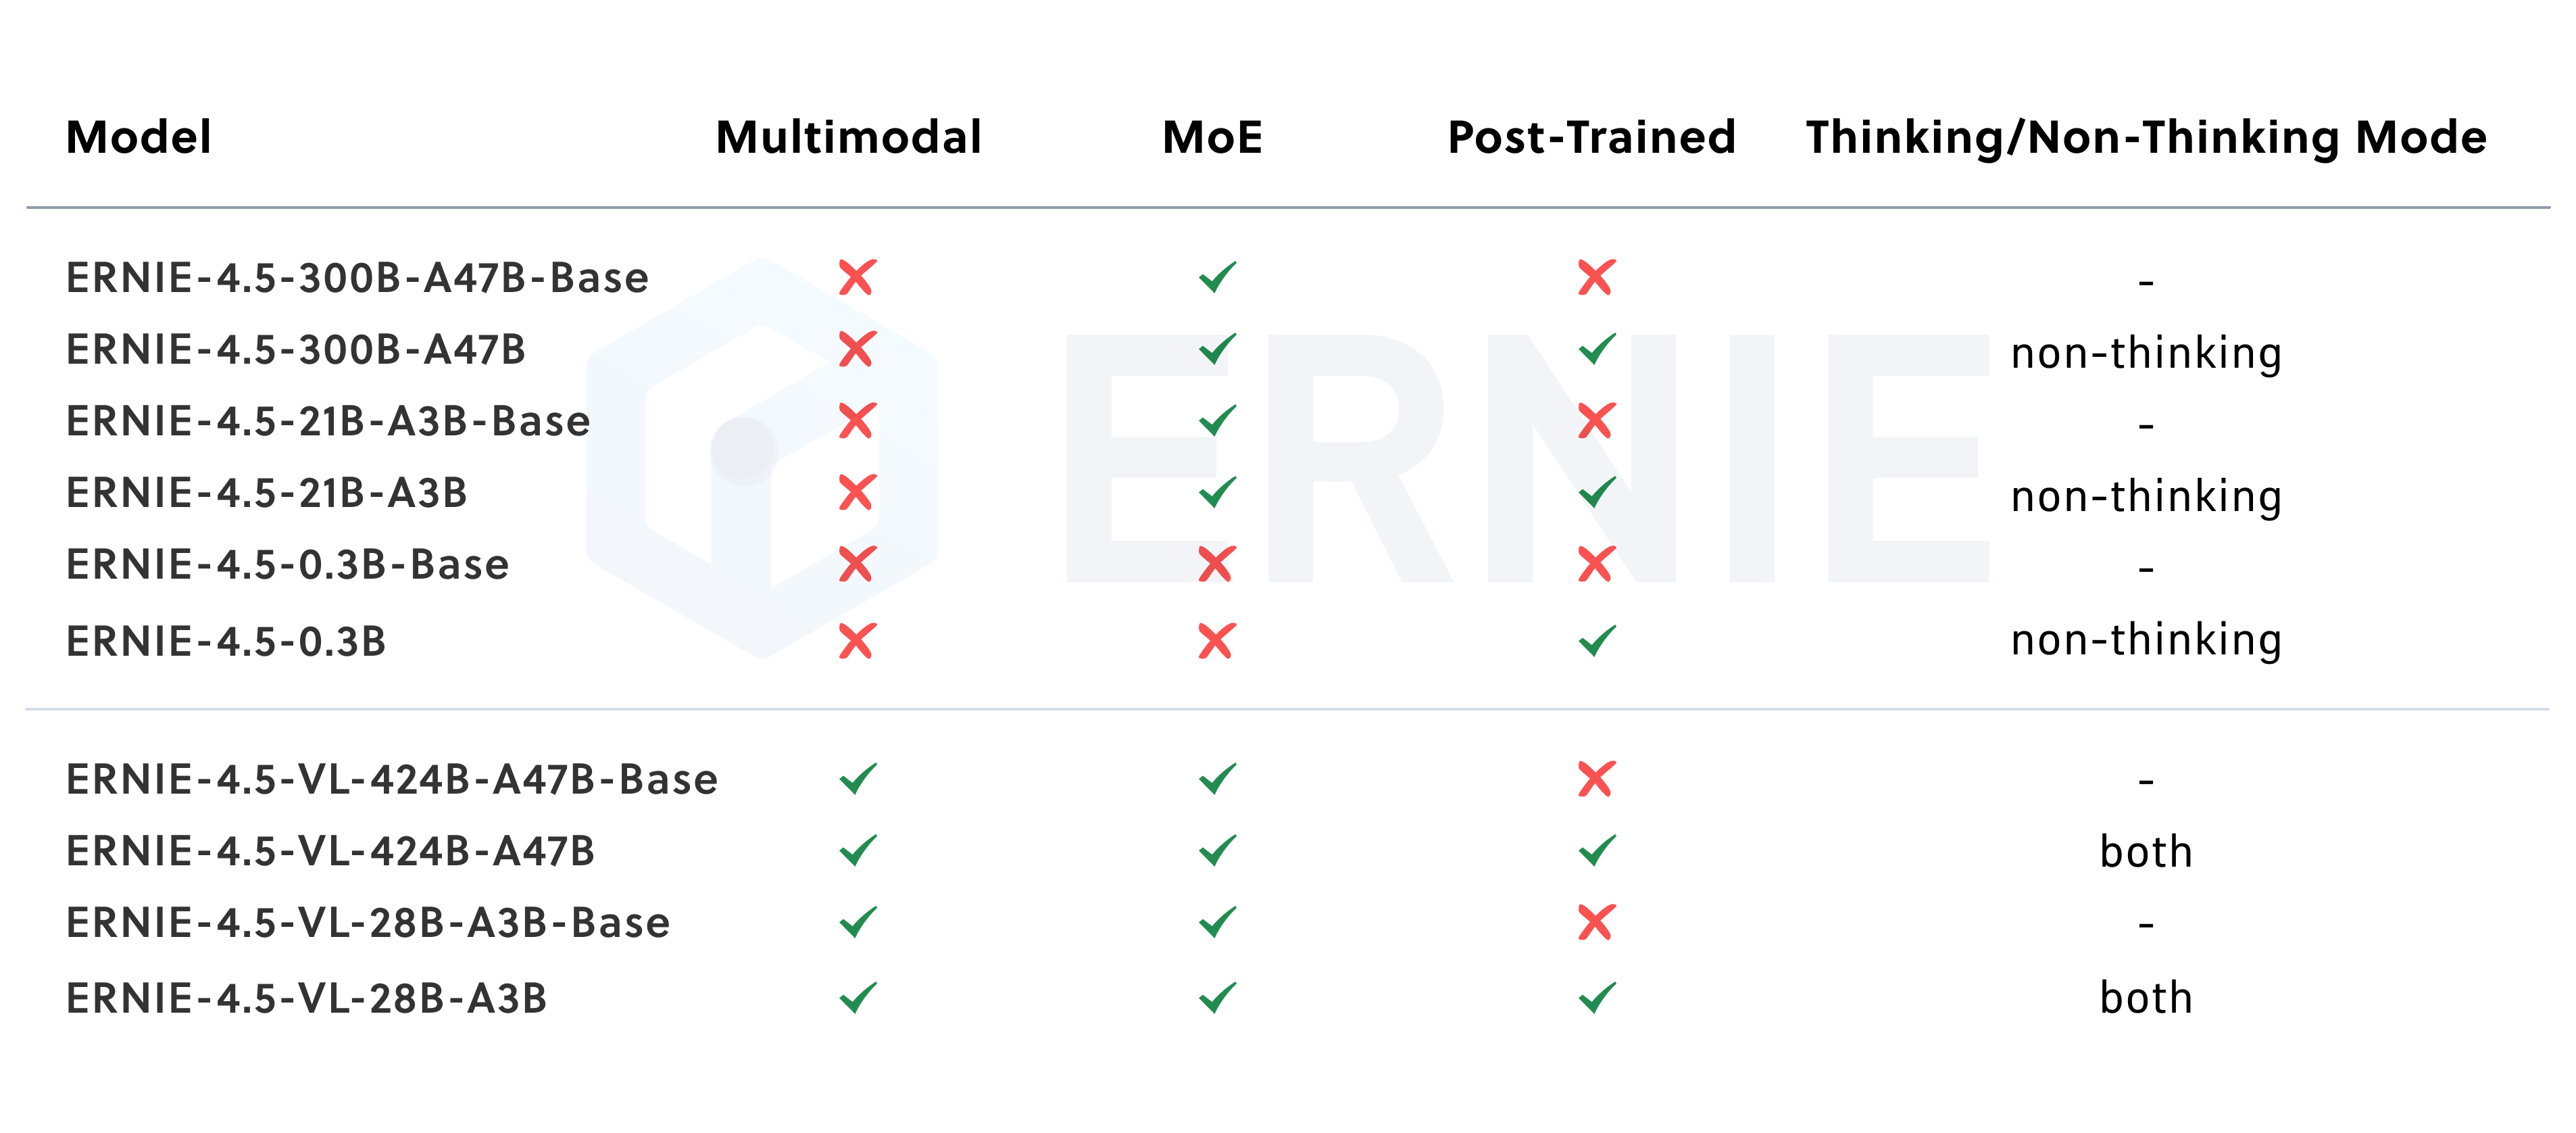
O modelo Ernie 4.5 Moe foi lançado na versão Ernie 4.5 Model Family pela baidu. Essa família de modelos contém diversas arquiteturas e tamanhos de modelos diferentes. Este modelo específico visa o modelo de texto base com mixture of experts (moe) - um com 21B de parâmetros totais e 3B de parâmetros ativos e outro com 300B de parâmetros totais e 47B de parâmetros ativos. Ele usa o padrão Llama em seu núcleo, combinado com um MoE especializado baseado em Mixtral com especialistas compartilhados adicionais.
Outros modelos da família podem ser encontrados em Ernie 4.5 e Ernie 4.5 VL MoE.
Dicas de uso
Gerar texto
from transformers import AutoModelForCausalLM, AutoTokenizer


model_name = "baidu/ERNIE-4.5-21B-A3B-PT"

# load the tokenizer and the model
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map="auto",
)

# prepare the model input
inputs = tokenizer("Hey, are you conscious? Can you talk to me?", return_tensors="pt").to(model.device)
prompt = "Hey, are you conscious? Can you talk to me?"
messages = [
    {"role": "user", "content": prompt}
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True
)
model_inputs = tokenizer([text], add_special_tokens=False, return_tensors="pt").to(model.device)

# conduct text completion
generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=32,
)
output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()

# decode the generated ids
generate_text = tokenizer.decode(output_ids, skip_special_tokens=True)
Geração Distribuída com Paralelismo de Tensor
from transformers import AutoModelForCausalLM, AutoTokenizer


model_name = "baidu/ERNIE-4.5-21B-A3B-PT"

# load the tokenizer and the model
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map="auto",
    tp_plan="auto",
)

# prepare the model input
inputs = tokenizer("Hey, are you conscious? Can you talk to me?", return_tensors="pt").to(model.device)
prompt = "Hey, are you conscious? Can you talk to me?"
messages = [
    {"role": "user", "content": prompt}
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True
)
model_inputs = tokenizer([text], add_special_tokens=False, return_tensors="pt").to(model.device)

# conduct text completion
generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=32,
)
output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()

# decode the generated ids
generate_text = tokenizer.decode(output_ids, skip_special_tokens=True)
Quantização com Bitsandbytes
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig


model_name = "baidu/ERNIE-4.5-21B-A3B-PT"

# load the tokenizer and the model
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(
    model_name,
    device_map="auto",
    quantization_config=BitsAndBytesConfig(load_in_4bit=True),
)

# prepare the model input
inputs = tokenizer("Hey, are you conscious? Can you talk to me?", return_tensors="pt").to(model.device)
prompt = "Hey, are you conscious? Can you talk to me?"
messages = [
    {"role": "user", "content": prompt}
]
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True
)
model_inputs = tokenizer([text], add_special_tokens=False, return_tensors="pt").to(model.device)

# conduct text completion
generated_ids = model.generate(
    **model_inputs,
    max_new_tokens=32,
)
output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()

# decode the generated ids
generate_text = tokenizer.decode(output_ids, skip_special_tokens=True)
Este modelo foi contribuído por Anton Vlasjuk. O código original pode ser encontrado aqui.
Ernie4_5_MoeConfig
classe transformers.Ernie4_5_MoeConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 103424pad_token_id: int | None = 0bos_token_id: int | None = 1eos_token_id: int | list[int] | None = 2hidden_size: int = 2560intermediate_size: int = 12288num_hidden_layers: int = 28num_attention_heads: int = 20num_key_value_heads: int | None = 4hidden_act: str = 'silu'max_position_embeddings: int = 131072initializer_range: float = 0.02rms_norm_eps: float = 1e-05use_cache: bool = Truetie_word_embeddings: bool = Truerope_parameters: transformers.modeling_rope_utils.RopeParameters | dict | None = Noneuse_bias: bool | None = Falsemoe_intermediate_size: int = 1536moe_k: int | None = 6moe_num_experts: int | None = 64moe_num_shared_experts: int | None = 2moe_layer_start_index: int | None = 1moe_layer_end_index: int | None = -1moe_layer_interval: int | None = 1moe_norm_min: float | None = 1e-12output_router_logits: bool | None = Falserouter_aux_loss_coef: float | None = 0.001 )
Parâmetros
- vocab_size (
int, opcional, padrão103424) — Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelosinput_ids. - pad_token_id (
int, opcional, padrão0) — ID do token usado para preenchimento no vocabulário. - bos_token_id (
int, opcional, padrão1) — ID do token usado para o início do fluxo no vocabulário. - eos_token_id (
Union[int, list[int]], opcional, padrão2) — ID do token usado para o fim do fluxo no vocabulário. - hidden_size (
int, opcional, padrão2560) — Dimensão das representações ocultas. - intermediate_size (
int, opcional, padrão12288) — Dimensão das representações do MLP. - num_hidden_layers (
int, opcional, padrão28) — Número de camadas ocultas no decodificador do Transformer. - num_attention_heads (
int, opcional, padrão20) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - num_key_value_heads (
int, opcional, padrão4) — Este é o número de cabeças de key_value que devem ser usadas para implementar Grouped Query Attention. Senum_key_value_heads=num_attention_heads, o modelo usará Multi Head Attention (MHA); senum_key_value_heads=1, o modelo usará Multi Query Attention (MQA); caso contrário, será usado GQA. Ao converter um checkpoint multi-head para um checkpoint GQA, cada grupo de cabeças de chave e valor deve ser construído por meio do meanpooling de todas as cabeças originais dentro desse grupo. Para mais detalhes, consulte este artigo. Se não for especificado, o valor padrão seránum_attention_heads. - hidden_act (
str, opcional, padrãosilu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - max_position_embeddings (
int, opcional, padrão131072) — O comprimento máximo de sequência com o qual este modelo pode ser utilizado. - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - rms_norm_eps (
float, opcional, padrão1e-05) — O epsilon usado pelas camadas de normalização rms. - use_cache (
bool, opcional, padrãoTrue) — Se o modelo deve ou não retornar as últimas chaves/valores de atenção (não usado por todos os modelos). Relevante apenas seconfig.is_decoder=Trueou quando o modelo for um modelo generativo somente decodificador. - tie_word_embeddings (
bool, opcional, padrãoTrue) — Se deve vincular as embeddings de pesos de acordo com o mapeamentotied_weights_keysdo modelo. - rope_parameters (
Union[~modeling_rope_utils.RopeParameters, dict], opcional) — Dicionário contendo os parâmetros de configuração para os embeddings RoPE. O dicionário deve conter um valor pararope_thetae, opcionalmente, parâmetros usados para escalonamento, caso você queira usar RoPE commax_position_embeddingsmaiores. - use_bias (
bool, opcional, padrãoFalse) — Se deve usar um viés em qualquer uma das projeções, incluindo mlp e atenção, por exemplo. - moe_intermediate_size (
int, opcional, padrão1536) — Tamanho intermediário dos MLPs dos especialistas roteados. - moe_k (
int, opcional, padrão 6) — Número de especialistas selecionados. - moe_num_experts (
int, opcional, padrão 64) — Número de especialistas roteados. - moe_num_shared_experts (
int, opcional, padrão 2) — O número de especialistas compartilhados para todos os forwards de MoE. - moe_layer_start_index (
int, opcional, padrão 1) — O primeiro índice a partir do qual as camadas MoE começam a aparecer. - moe_layer_end_index (
int, opcional, padrão -1) — O último índice possível para uma camada MoE. - moe_layer_interval (
int, opcional, padrão 1) — Os intervalos entre as camadas MoE a serem exibidas. - moe_norm_min (
float, opcional, padrão 1e-12) — Valor mínimo de divisão durante a normalização de roteamento. - output_router_logits (
bool, opcional, padrãoFalse) — Indica se os logits do roteador devem ser retornados pelo modelo. Ativar essa opção também permitirá que o modelo saída a perda auxiliar, incluindo a perda de balanceamento de carga e a perda z do roteador. - router_aux_loss_coef (
float, opcional, padrão0.001) — Coeficiente da perda auxiliar de balanceamento de carga. Usado para penalizar o roteamento desigual de especialistas em modelos MoE.
Esta é a classe de configuração para armazenar a configuração de um Ernie4_5_MoeModel. Ela é usada para instanciar um modelo Ernie4 5 Moe de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do baidu/ERNIE-4.5-21B-A3B-PT
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
Exemplo:
>>> from transformers import Ernie4_5_MoeModel, Ernie4_5_MoEConfig

>>> # Initializing a Ernie4_5_MoE style configuration
>>> configuration = Ernie4_5_MoEConfig()

>>> # Initializing a model from the ERNIE-4.5-21B-A3B style configuration
>>> model = Ernie4_5_MoeModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
Ernie4_5_MoeModel
classe transformers.Ernie4_5_MoeModel
< source >( config: Ernie4_5_MoeConfig )
Parâmetros
- config (Ernie4_5_MoeConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo Ernie4 5 Moe sem nenhum head específico no topo, produzindo hidden-states brutos.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeModelOutputWithPast or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- position_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, opcional) — Estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nopast_key_valuesretornado pelo modelo em uma etapa anterior da decodificação, quandouse_cache=Trueouconfig.use_cache=True.Apenas uma instância de Cache é permitida como entrada, consulte nosso guia de cache de kv. Se nenhum
past_key_valuesfor passado, DynamicCache será inicializado por padrão.O modelo sairá no mesmo formato de cache que é fornecido como entrada.
Se
past_key_valuesforem usados, espera-se que o usuário insira apenas osinput_idsnão processados (aqueles que não têm seus estados de chave e valor passados fornecidos a este modelo) com a forma(batch_size, unprocessed_length), em vez de todos osinput_idscom a forma(batch_size, sequence_length). - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - use_cache (
bool, opcional) — Se definido comoTrue, os estados de chave-valorpast_key_valuessão retornados e podem ser usados para acelerar a decodificação (vejapast_key_values).
Retorna
MoeModelOutputWithPast ou tuple(torch.Tensor)
Um MoeModelOutputWithPast ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (Ernie4_5_MoeConfig) e das entradas.
O método forward do Ernie4_5_MoeModel sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size)) — Sequência de estados ocultos na saída da última camada do modelo.past_key_values (
Cache, opcional, retornado quandouse_cache=Trueé passado ou quandoconfig.use_cache=True) — É uma instância de Cache. Para mais detalhes, consulte nosso guia de cache kv.Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e, opcionalmente, se
config.is_encoder_decoder=True, nos blocos de atenção cruzada) que podem ser usados (veja a entradapast_key_values) para acelerar a decodificação sequencial.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
router_logits (
tuple(torch.Tensor), opcional, retornado quandooutput_router_probs=Trueeconfig.add_router_probs=Truesão passados ou quandoconfig.output_router_probs=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, sequence_length, num_experts).Logits brutos do roteador (pós-softmax) calculados pelos roteadores MoE; esses termos são usados para calcular a perda auxiliar em modelos Mixture of Experts.
Ernie4_5_MoeForCausalLM
classe transformers.Ernie4_5_MoeForCausalLM
< source >( config: Ernie4_5_MoeConfig )
Parâmetros
- config (Ernie4_5_MoeConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O Modelo Ernie4 5 Moe para modelagem de linguagem causal.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Noneoutput_router_logits: bool | None = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeCausalLMOutputWithPast or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- position_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, opcional) — Estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nopast_key_valuesretornado pelo modelo em uma etapa anterior da decodificação, quandouse_cache=Trueouconfig.use_cache=True.Apenas uma instância de Cache é permitida como entrada, consulte nosso guia de cache de kv. Se nenhum
past_key_valuesfor passado, DynamicCache será inicializado por padrão.O modelo sairá no mesmo formato de cache que é fornecido como entrada.
Se
past_key_valuesforem usados, espera-se que o usuário insira apenas osinput_idsnão processados (aqueles que não têm seus estados de chave e valor passados fornecidos a este modelo) com a forma(batch_size, unprocessed_length), em vez de todos osinput_idscom a forma(batch_size, sequence_length). - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - labels (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Rótulos para o cálculo da perda de modelagem de linguagem mascarada. Os índices devem estar em[0, ..., config.vocab_size]ou ser -100 (veja a docstring deinput_ids). Tokens com índices definidos como-100são ignorados (mascarados); a perda é calculada apenas para os tokens com rótulos em[0, ..., config.vocab_size]. - use_cache (
bool, opcional) — Se definido comoTrue, os estados de chave-valorpast_key_valuessão retornados e podem ser usados para acelerar a decodificação (vejapast_key_values). - output_router_logits (
bool, opcional) — Indica se os logits de todos os roteadores devem ser retornados. Eles são úteis para calcular a perda do roteador e não devem ser retornados durante a inferência. - logits_to_keep (
Union[int, torch.Tensor], opcional, padrão0) — Se for umint, calcula os logits para os últimoslogits_to_keeptokens. Se for0, calcula os logits para todos osinput_ids(caso especial). Apenas os logits do último token são necessários para a geração, e calculá-los apenas para esse token pode economizar memória, o que se torna bastante significativo para sequências longas ou tamanho de vocabulário grande. Se for umtorch.Tensor, deve ser 1D, correspondendo aos índices a serem mantidos na dimensão de comprimento da sequência. Isso é útil ao usar o formato de tensor empacotado (uma única dimensão para lote e comprimento da sequência).
Retorna
MoeCausalLMOutputWithPast ou tuple(torch.Tensor)
Um MoeCausalLMOutputWithPast ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (Ernie4_5_MoeConfig) e das entradas.
O método forward de Ernie4_5_MoeForCausalLM substitui o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de modelagem de linguagem (para previsão do próximo token).logits (
torch.Tensorde forma(batch_size, sequence_length, config.vocab_size)) — Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).aux_loss (
torch.Tensor, opcional, retornado quandooutput_router_logits=Trueé passado ou quandoconfig.output_router_logits=True, e o modelo treina seu roteador com uma perda de balanceamento de carga) — Perda auxiliar de balanceamento de carga para os módulos esparsos. Modelos que equilibram seus especialistas com um viés de roteador em vez disso (DeepSeek-V3 e as arquiteturas derivadas dele) retornamNoneaqui, mas ainda retornamrouter_logits.router_logits (
tuple(torch.Tensor), opcional, retornado quandooutput_router_logits=Trueé passado ou quandoconfig.output_router_logits=True) — Tupla detorch.Tensor(um para cada camada esparsa) com forma(batch_size * sequence_length, num_experts).Logits brutos do roteador calculados pelos roteadores MoE. Podem ser usados para calcular uma perda de balanceamento de carga ou para inspecionar como os tokens são distribuídos entre os especialistas.
past_key_values (
Cache, opcional, retornado quandouse_cache=Trueé passado ou quandoconfig.use_cache=True) — É uma instância de Cache. Para mais detalhes, consulte nosso guia de cache kv.Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção) que podem ser usados (veja a entrada
past_key_values) para acelerar a decodificação sequencial.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
generate
< source >( inputs: typing.Optional[torch.Tensor] = Nonegeneration_config: transformers.generation.configuration_utils.GenerationConfig | None = Nonelogits_processor: transformers.generation.logits_process.LogitsProcessorList | None = Nonestopping_criteria: transformers.generation.stopping_criteria.StoppingCriteriaList | None = Noneprefix_allowed_tokens_fn: collections.abc.Callable[[int, torch.Tensor], list[int]] | None = Nonesynced_gpus: bool | None = Noneassistant_model: typing.Optional[ForwardRef('PreTrainedModel')] = Nonestreamer: typing.Optional[ForwardRef('BaseStreamer')] = Nonenegative_prompt_ids: typing.Optional[torch.Tensor] = Nonenegative_prompt_attention_mask: typing.Optional[torch.Tensor] = Nonecustom_generate: str | collections.abc.Callable | None = None**kwargs ) → ModelOutput or torch.LongTensor
Parâmetros
- inputs (
torch.Tensorde forma variável dependendo da modalidade, opcional) — A sequência usada como prompt para a geração ou como entrada do modelo para o codificador. SeNone, o método a inicializa combos_token_ide um tamanho de lote de 1. Para modelos apenas de decodificador,inputsdeve estar no formato deinput_ids. Para modelos codificador-decodificador, inputs pode representar qualquer um deinput_ids,input_values,input_featuresoupixel_values. - generation_config (GenerationConfig, opcional) —
A configuração de geração a ser usada como parametrização base para a chamada de geração. Os
**kwargspassados para generate que correspondam aos atributos degeneration_configos sobrescreverão. Segeneration_confignão for fornecido, o padrão será usado, que tem a seguinte prioridade de carregamento: 1) do arquivo de modelogeneration_config.json, se existir; 2) da configuração do modelo. Observe que os parâmetros não especificados herdarão os valores padrão de GenerationConfig, cuja documentação deve ser consultada para parametrizar a geração. - logits_processor (
LogitsProcessorList, opcional) — Processadores de logits personalizados que complementam os processadores de logits padrão criados a partir dos argumentos e da configuração de geração. Se um processador de logits for passado que já foi criado com os argumentos ou com uma configuração de geração, um erro será lançado. Este recurso é destinado a usuários avançados. - stopping_criteria (
StoppingCriteriaList, opcional) — Critérios de parada personalizados que complementam os critérios de parada padrão criados a partir dos argumentos e de uma configuração de geração. Se um critério de parada for passado que já foi criado com os argumentos ou com uma configuração de geração, um erro será lançado. Se o seu critério de parada depende da entradascores, certifique-se de passarreturn_dict_in_generate=True, output_scores=Trueparagenerate. Este recurso é destinado a usuários avançados. - prefix_allowed_tokens_fn (
Callable[[int, torch.Tensor], list[int]], opcional) — Se fornecida, esta função restringe a busca por feixe apenas aos tokens permitidos em cada etapa. Se não for fornecida, nenhuma restrição é aplicada. Esta função recebe 2 argumentos: o ID do lotebatch_ideinput_ids. Ela deve retornar uma lista com os tokens permitidos para a próxima etapa de geração, condicionada ao ID do lotebatch_ide aos tokens gerados anteriormenteinputs_ids. Este argumento é útil para geração condicionada ao prefixo, conforme descrito em Autoregressive Entity Retrieval. - synced_gpus (
bool, opcional) — Se deve continuar executando o loop while até max_length. A menos que seja sobrescrito, este sinalizador será definido comoTrueao usarFullyShardedDataParallelou DeepSpeed ZeRO Stage 3 com múltiplas GPUs para evitar deadlock caso uma GPU termine a geração antes das outras. Caso contrário, o valor padrão éFalse. - assistant_model (
PreTrainedModel, opcional) — Um modelo assistente que pode ser usado para acelerar a geração. O modelo assistente deve ter exatamente o mesmo tokenizer. A aceleração é obtida quando a previsão de tokens candidatos com o modelo assistente é muito mais rápida do que executar a geração com o modelo do qual você está chamando generate. Dessa forma, o modelo assistente deve ser muito menor. - streamer (
BaseStreamer, opcional) — Objeto que será usado para transmitir as sequências geradas. Os tokens gerados são passados porstreamer.put(token_ids)e o streamer é responsável por qualquer processamento adicional. - negative_prompt_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — O prompt negativo necessário para alguns processadores, como o CFG. O tamanho do lote deve corresponder ao tamanho do lote de entrada. Esta é uma funcionalidade experimental, sujeita a alterações na API que podem quebrar a compatibilidade em versões futuras. - negative_prompt_attention_mask (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Attention_mask paranegative_prompt_ids. - custom_generate (
strouCallable, opcional) — Um dos seguintes:str(nome do repositório no Hugging Face Hub): executa a função personalizadageneratedefinida emcustom_generate/generate.pynesse repositório, em vez do método padrãogenerate. O repositório substitui completamente a lógica de geração, e o tipo de retorno pode ser diferente.str(caminho do repositório local): o mesmo que acima, mas a partir de um caminho local. Diretórios locais também exigemtrust_remote_code=Trueporque ocustom_generate/generate.pylocal é executado.Callable:generateexecutará as etapas habituais de preparação da entrada e, em seguida, chamará a função fornecida para executar o loop de decodificação. Para mais informações, consulte a documentação.
- kwargs (
dict[str, Any], opcional) — Parametrização ad hoc degeneration_confige/ou kwargs específicos do modelo adicionais que serão encaminhados para a funçãoforwarddo modelo. Se o modelo for um modelo encoder-decoder, os kwargs específicos do encoder não devem ter prefixo e os kwargs específicos do decoder devem ter o prefixo decoder_.
Retorna
ModelOutput ou torch.LongTensor
Um ModelOutput (se return_dict_in_generate=True
ou quando config.return_dict_in_generate=True) ou um torch.LongTensor.
Se o modelo não for um modelo encoder-decoder (model.config.is_encoder_decoder=False), os tipos possíveis de
ModelOutput são:
Se o modelo for um modelo encoder-decoder (model.config.is_encoder_decoder=True), os tipos possíveis de
ModelOutput são:
Gera sequências de ids de tokens para modelos com uma cabeça de modelagem de linguagem.
A maioria dos parâmetros de controle de geração é definida em
generation_config, que, se não for fornecida, será definida como a configuração de geração padrão do modelo. Você pode sobrescrever qualquergeneration_configpassando os parâmetros correspondentes para generate(), por exemplo,.generate(inputs, num_beams=4, do_sample=True).Para uma visão geral das estratégias de geração e exemplos de código, consulte o guia a seguir.