
Transformers documentation
GLM-5, GLM-5.1, GLM-5.2, GLM-5.3
Este modelo foi publicado em HF papers em 17/02/2026 e contribuído para Hugging Face Transformers em 09/02/2026.

GLM-5, GLM-5.1, GLM-5.2, GLM-5.3
Visão geral
Os modelos de linguagem GLM-5, GLM-5.1, GLM-5.2 e GLM-5.3 utilizam esta classe. A implementação no transformers não inclui uma camada MTP.
GLM-5.3
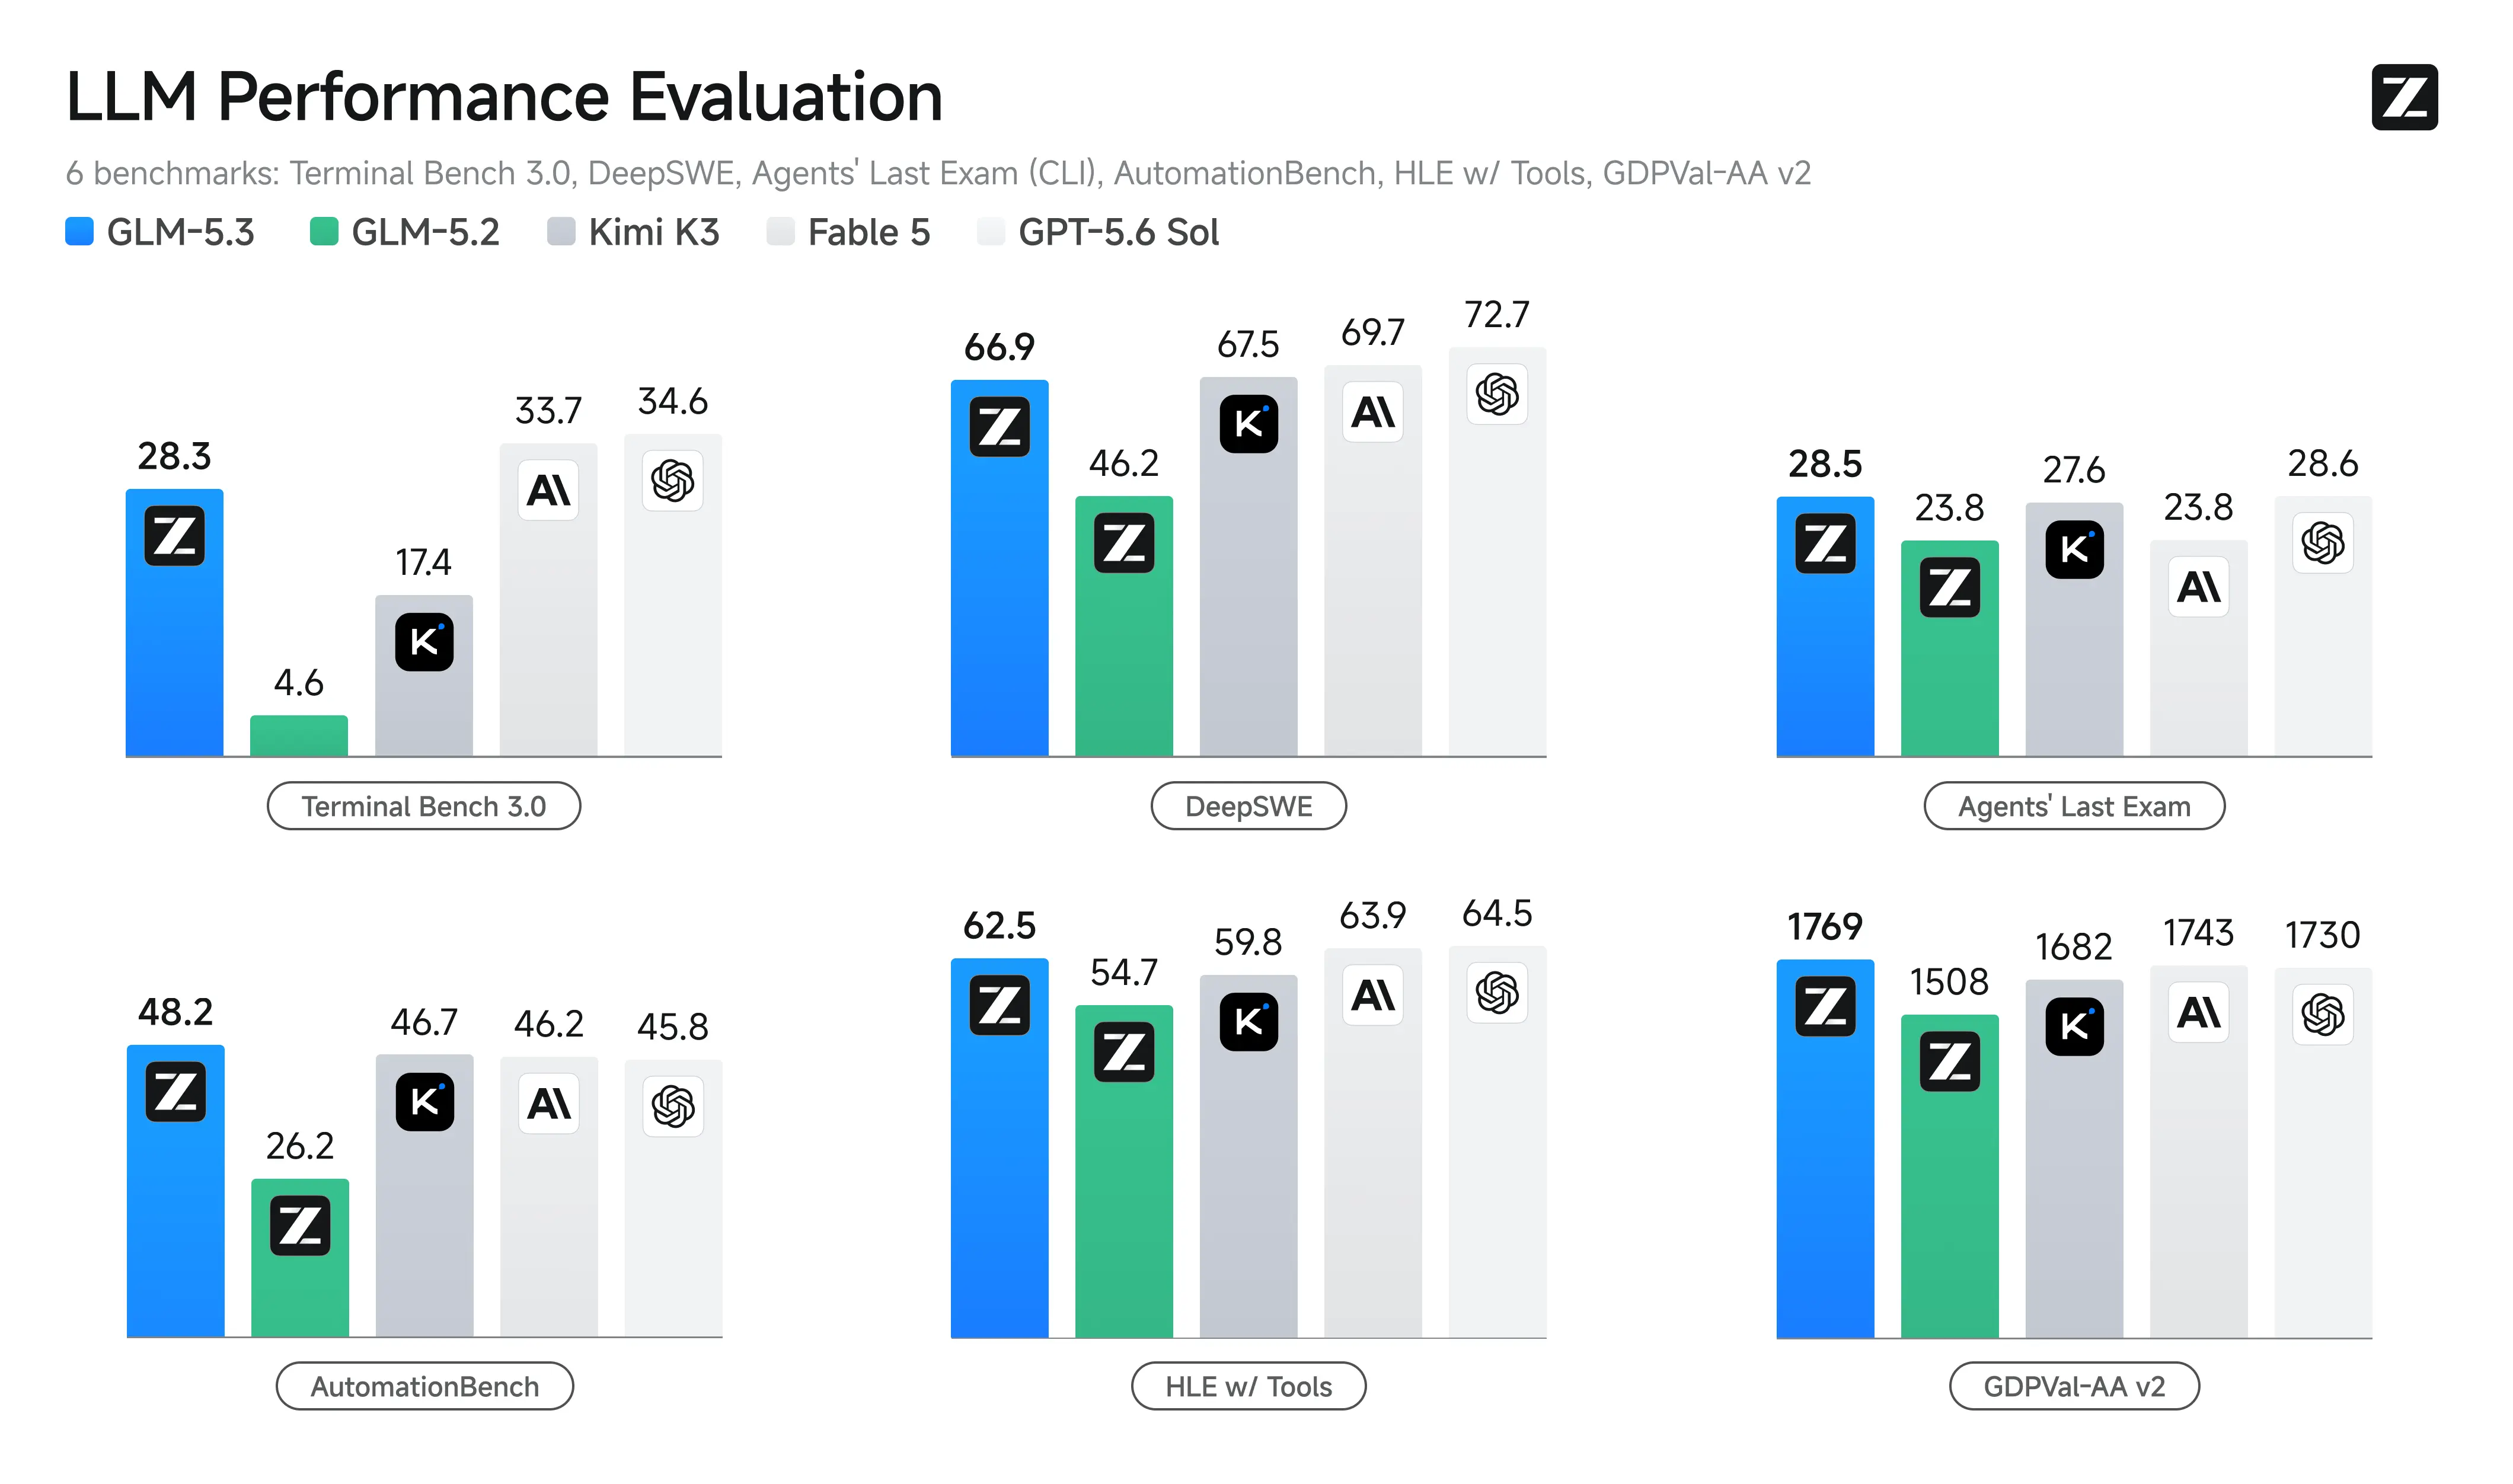
O GLM-5.3 utiliza o mesmo modelo base que o GLM-5.2 — todo o ganho vem do pós-treinamento. Em comparação com o GLM-5.2, ele é muito melhor em codificação complexa e em tarefas de longo prazo:
- Código mais robusto: o GLM-5.3 é o modelo de pesos abertos mais capaz para programação, com uma melhoria de 50% em relação ao GLM-5.2 no nosso Z.ai Code Bench interno. Ele também alcança o SOTA de código aberto em benchmarks públicos, incluindo Terminal Bench 3.0 e Agents’ Last Exam.
- Capacidade cibernética emergente: à medida que escalávamos o pós-treinamento, a capacidade cibernética se desenvolveu mais rápido do que esperávamos. O GLM-5.3 é o estado da arte no CyberGym para descoberta de vulnerabilidades, e seus ganhos são maiores mais adiante na cadeia de exploração, onde ele mais que dobra o GLM-5.2 em benchmarks de exploração.
GLM-5.2
GLM-5.2, nosso modelo principal mais recente para tarefas de longo prazo. Ele representa um avanço significativo na capacidade de execução de tarefas de longo prazo em relação ao seu antecessor, o GLM-5.1, e, pela primeira vez, oferece essa capacidade em um contexto sólido de 1M de tokens.
As novas capacidades do GLM-5.2 incluem:
- Contexto sólido de 1M: Um contexto sólido de 1M de tokens que sustenta de forma estável trabalhos de longo prazo
- Codificação avançada com esforço flexível: Capacidades de codificação aprimoradas com múltiplos níveis de esforço de raciocínio para equilibrar desempenho e latência
- Arquitetura aprimorada: propomos o IndexShare, que reutiliza o mesmo indexer em cada quatro camadas de atenção esparsa, reduzindo os FLOPs por token em 2,9× em um comprimento de contexto de 1M. Também aprimoramos a camada MTP do GLM-5.2 para decodificação especulativa, aumentando o comprimento de aceitação em até 20%
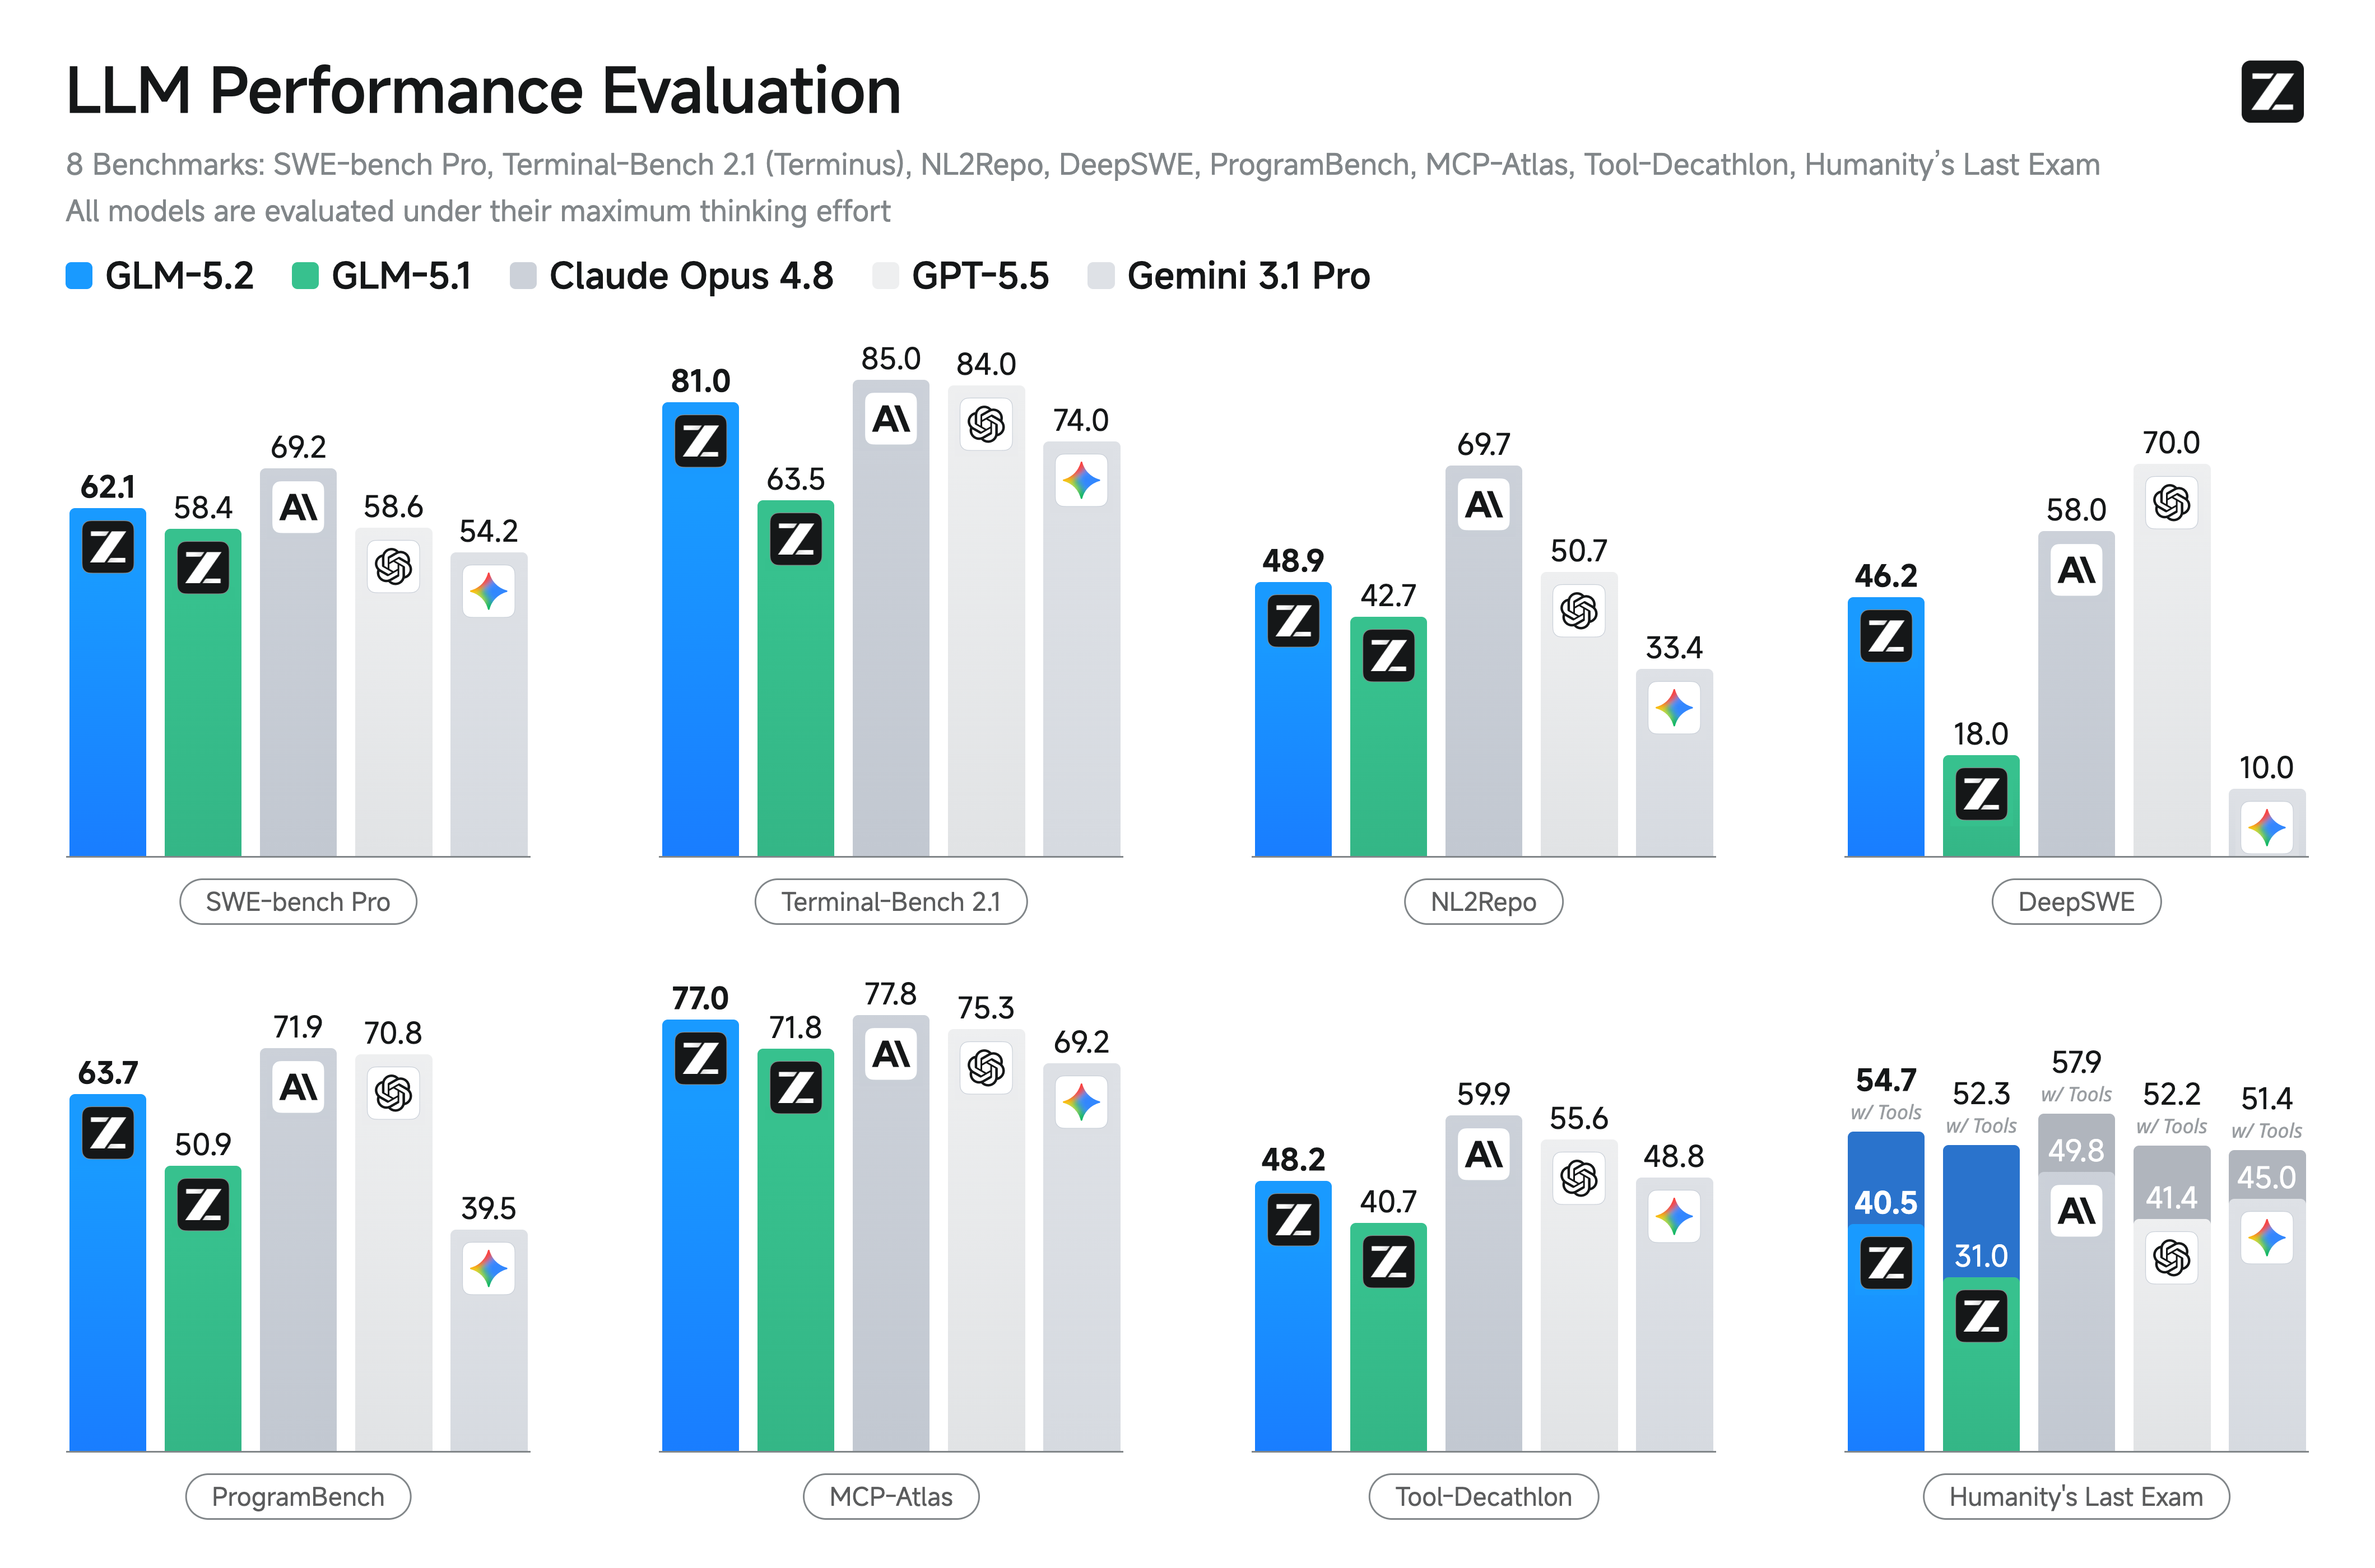
Em benchmarks padrão de programação, o GLM-5.2 é o modelo open-source mais forte, superando o GLM-5.1 por uma ampla margem: 81,0 contra 62,0 no Terminal-Bench 2.1 e 62,1 contra 58,4 no SWE-bench Pro. Ele também reduz grande parte da diferença em relação à fronteira de modelos fechados — no Terminal-Bench 2.1 (81,0), fica a poucos pontos do Claude Opus 4.8 (85,0) — mantendo-se à frente do Gemini 3.1 Pro.
Para mais detalhes, consulte nosso blog.
GLM-5.1
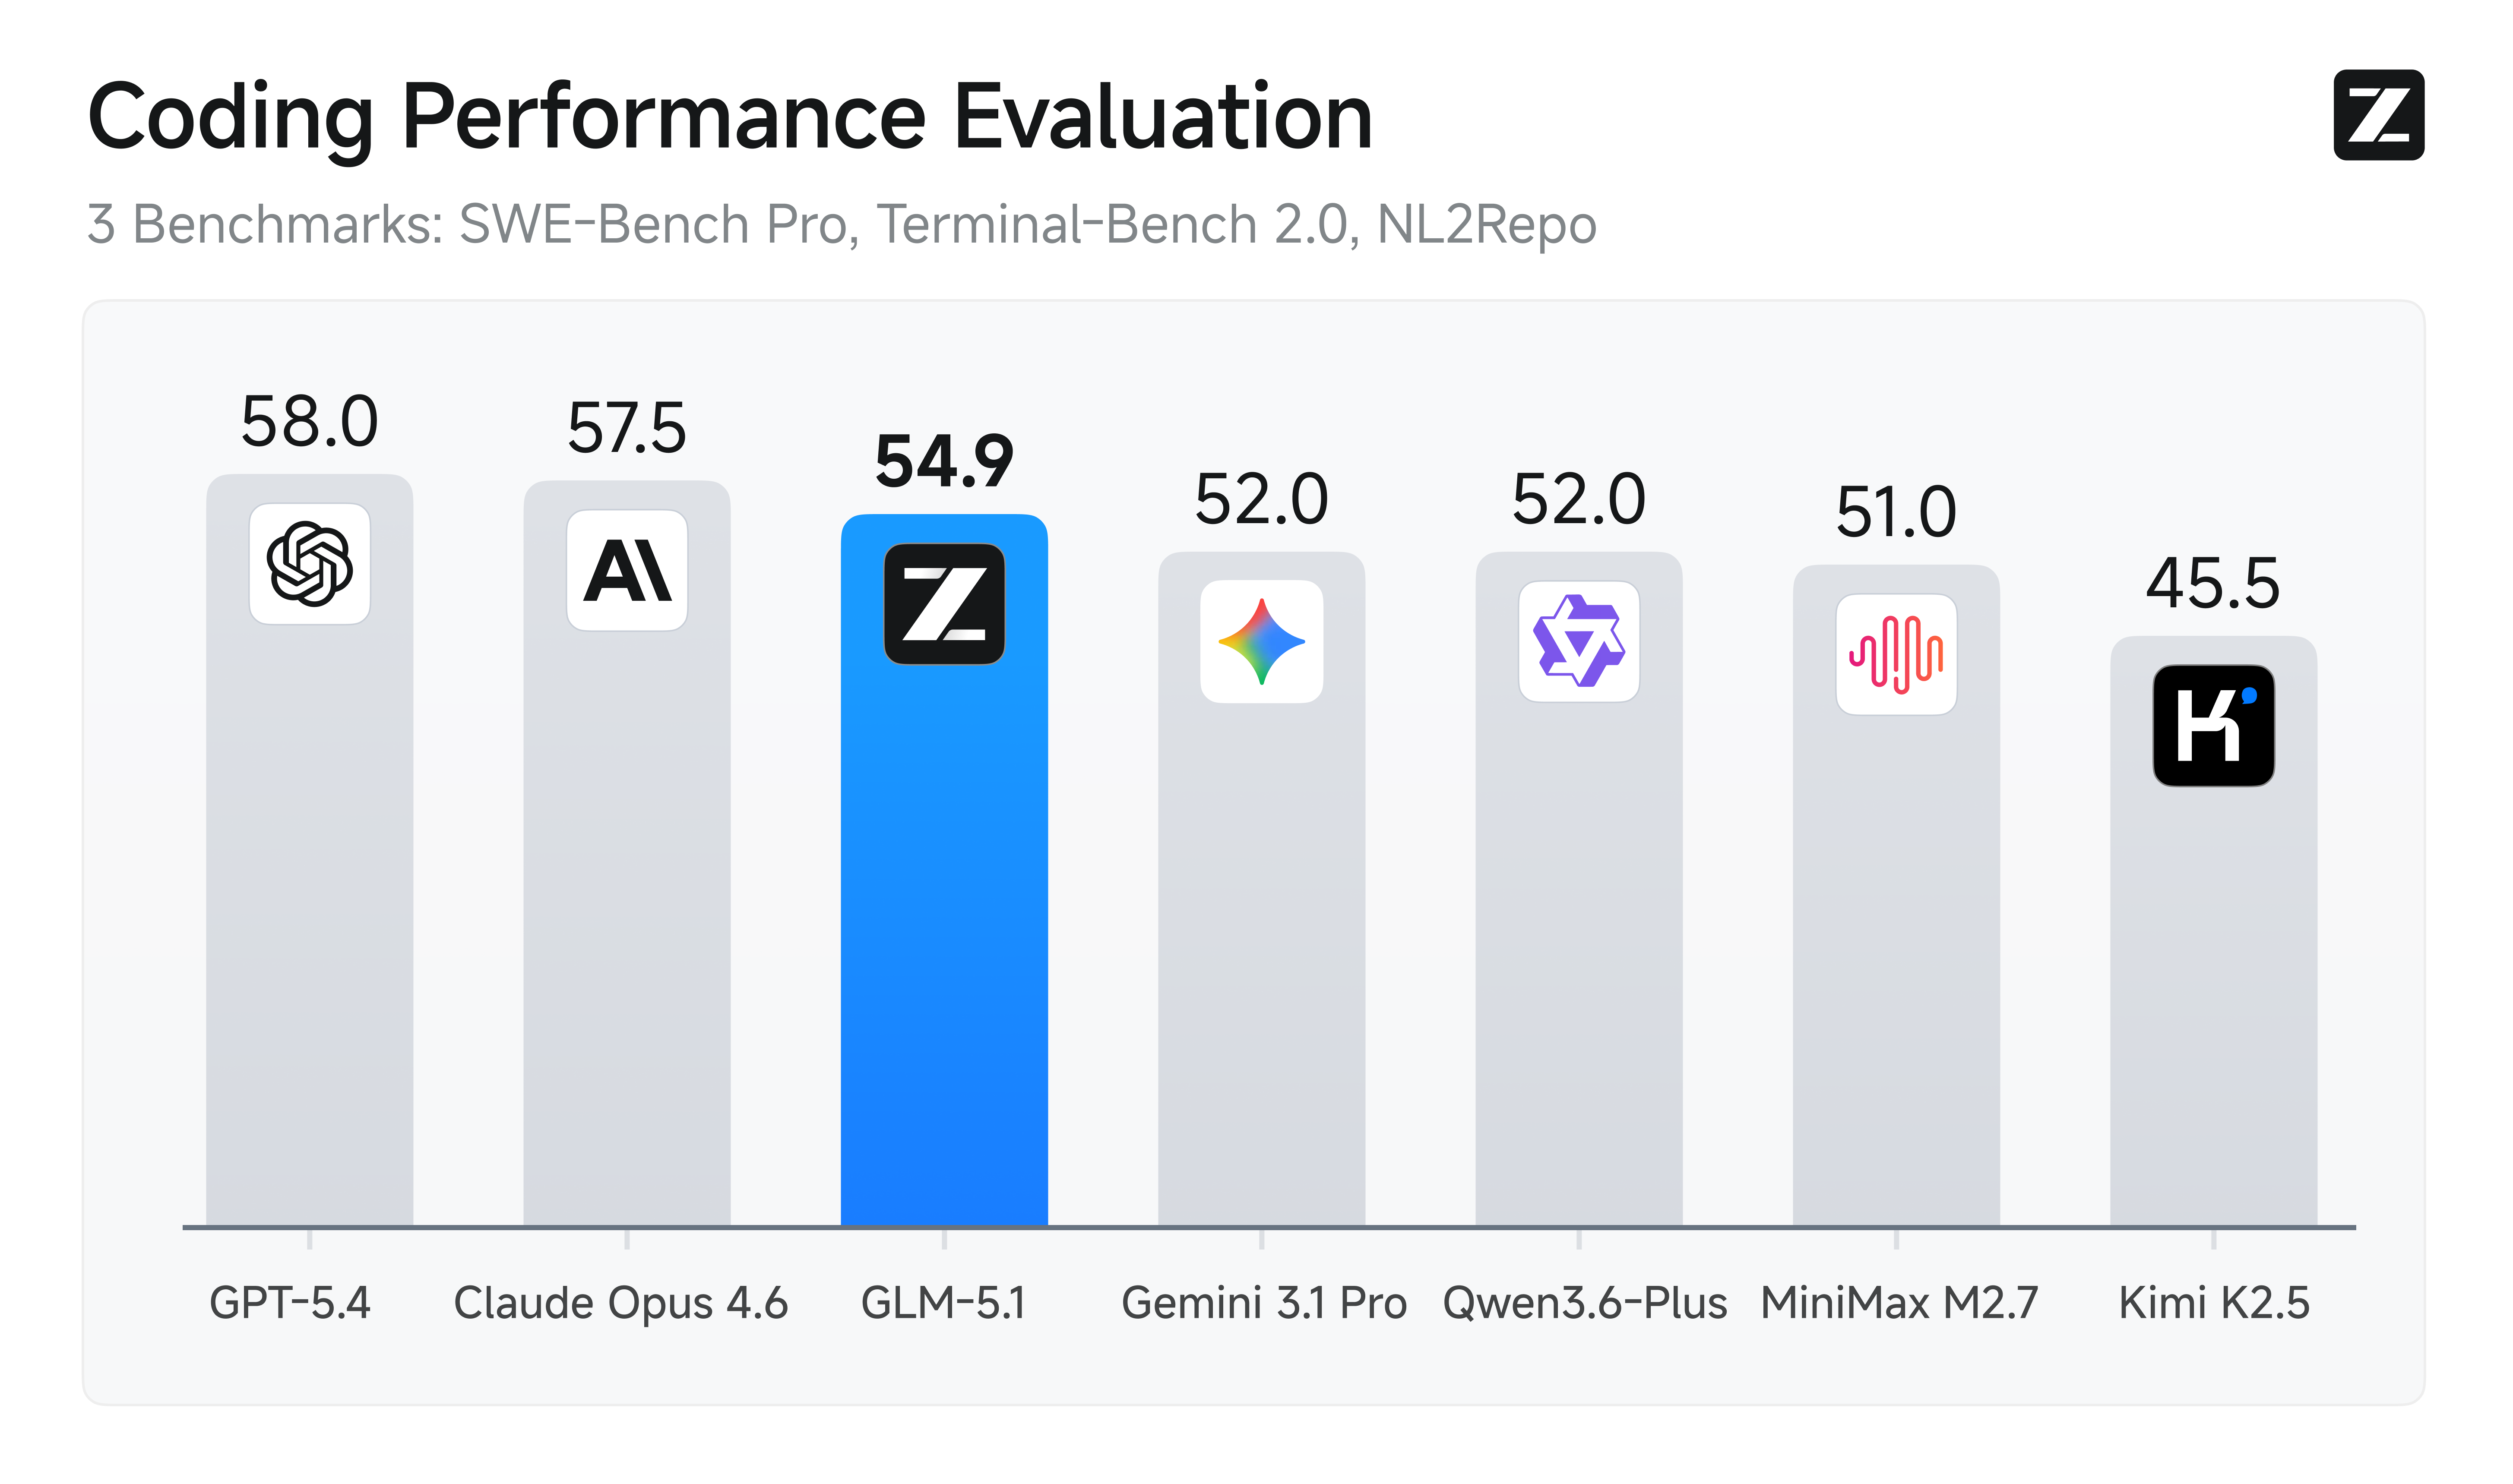
O GLM-5.1 é o nosso modelo principal de próxima geração para engenharia agêntica, com capacidades de codificação significativamente mais fortes do que seu antecessor. Ele atinge desempenho de estado da arte no SWE-Bench Pro e lidera o GLM-5 por uma ampla margem no NL2Repo (geração de repositório) e no Terminal-Bench 2.0 (tarefas de terminal do mundo real).
Mas o salto mais significativo vai além do desempenho na primeira tentativa. Modelos anteriores — incluindo o GLM-5 — tendem a esgotar seu repertório precocemente: aplicam técnicas familiares para ganhos iniciais rápidos e, em seguida, atingem um platô. Dar mais tempo a eles não ajuda.
Em contraste, o GLM-5.1 foi projetado para manter a eficácia em tarefas agênticas ao longo de horizontes muito mais longos. Verificamos que o modelo lida com problemas ambíguos com melhor julgamento e permanece produtivo em sessões mais longas. Ele decompõe problemas complexos, executa experimentos, lê os resultados e identifica bloqueios com precisão real. Ao revisar seu raciocínio e revisar sua estratégia por meio de iteração repetida, o GLM-5.1 sustenta a otimização ao longo de centenas de rodadas e milhares de chamadas de ferramentas. Quanto mais tempo ele executa, melhor o resultado.
GLM-5
O GLM-5 (GlmMoeDsa) é um modelo mixture-of-experts com 744 bilhões de parâmetros e 40 bilhões de parâmetros ativos por token, utilizando DeepSeek Sparse Attention (DSA) para processamento eficiente de contexto de 200K tokens. Ele foi treinado inteiramente em chips Huawei Ascend e apresenta desempenho de nível de fronteira em benchmarks de raciocínio e contexto longo.
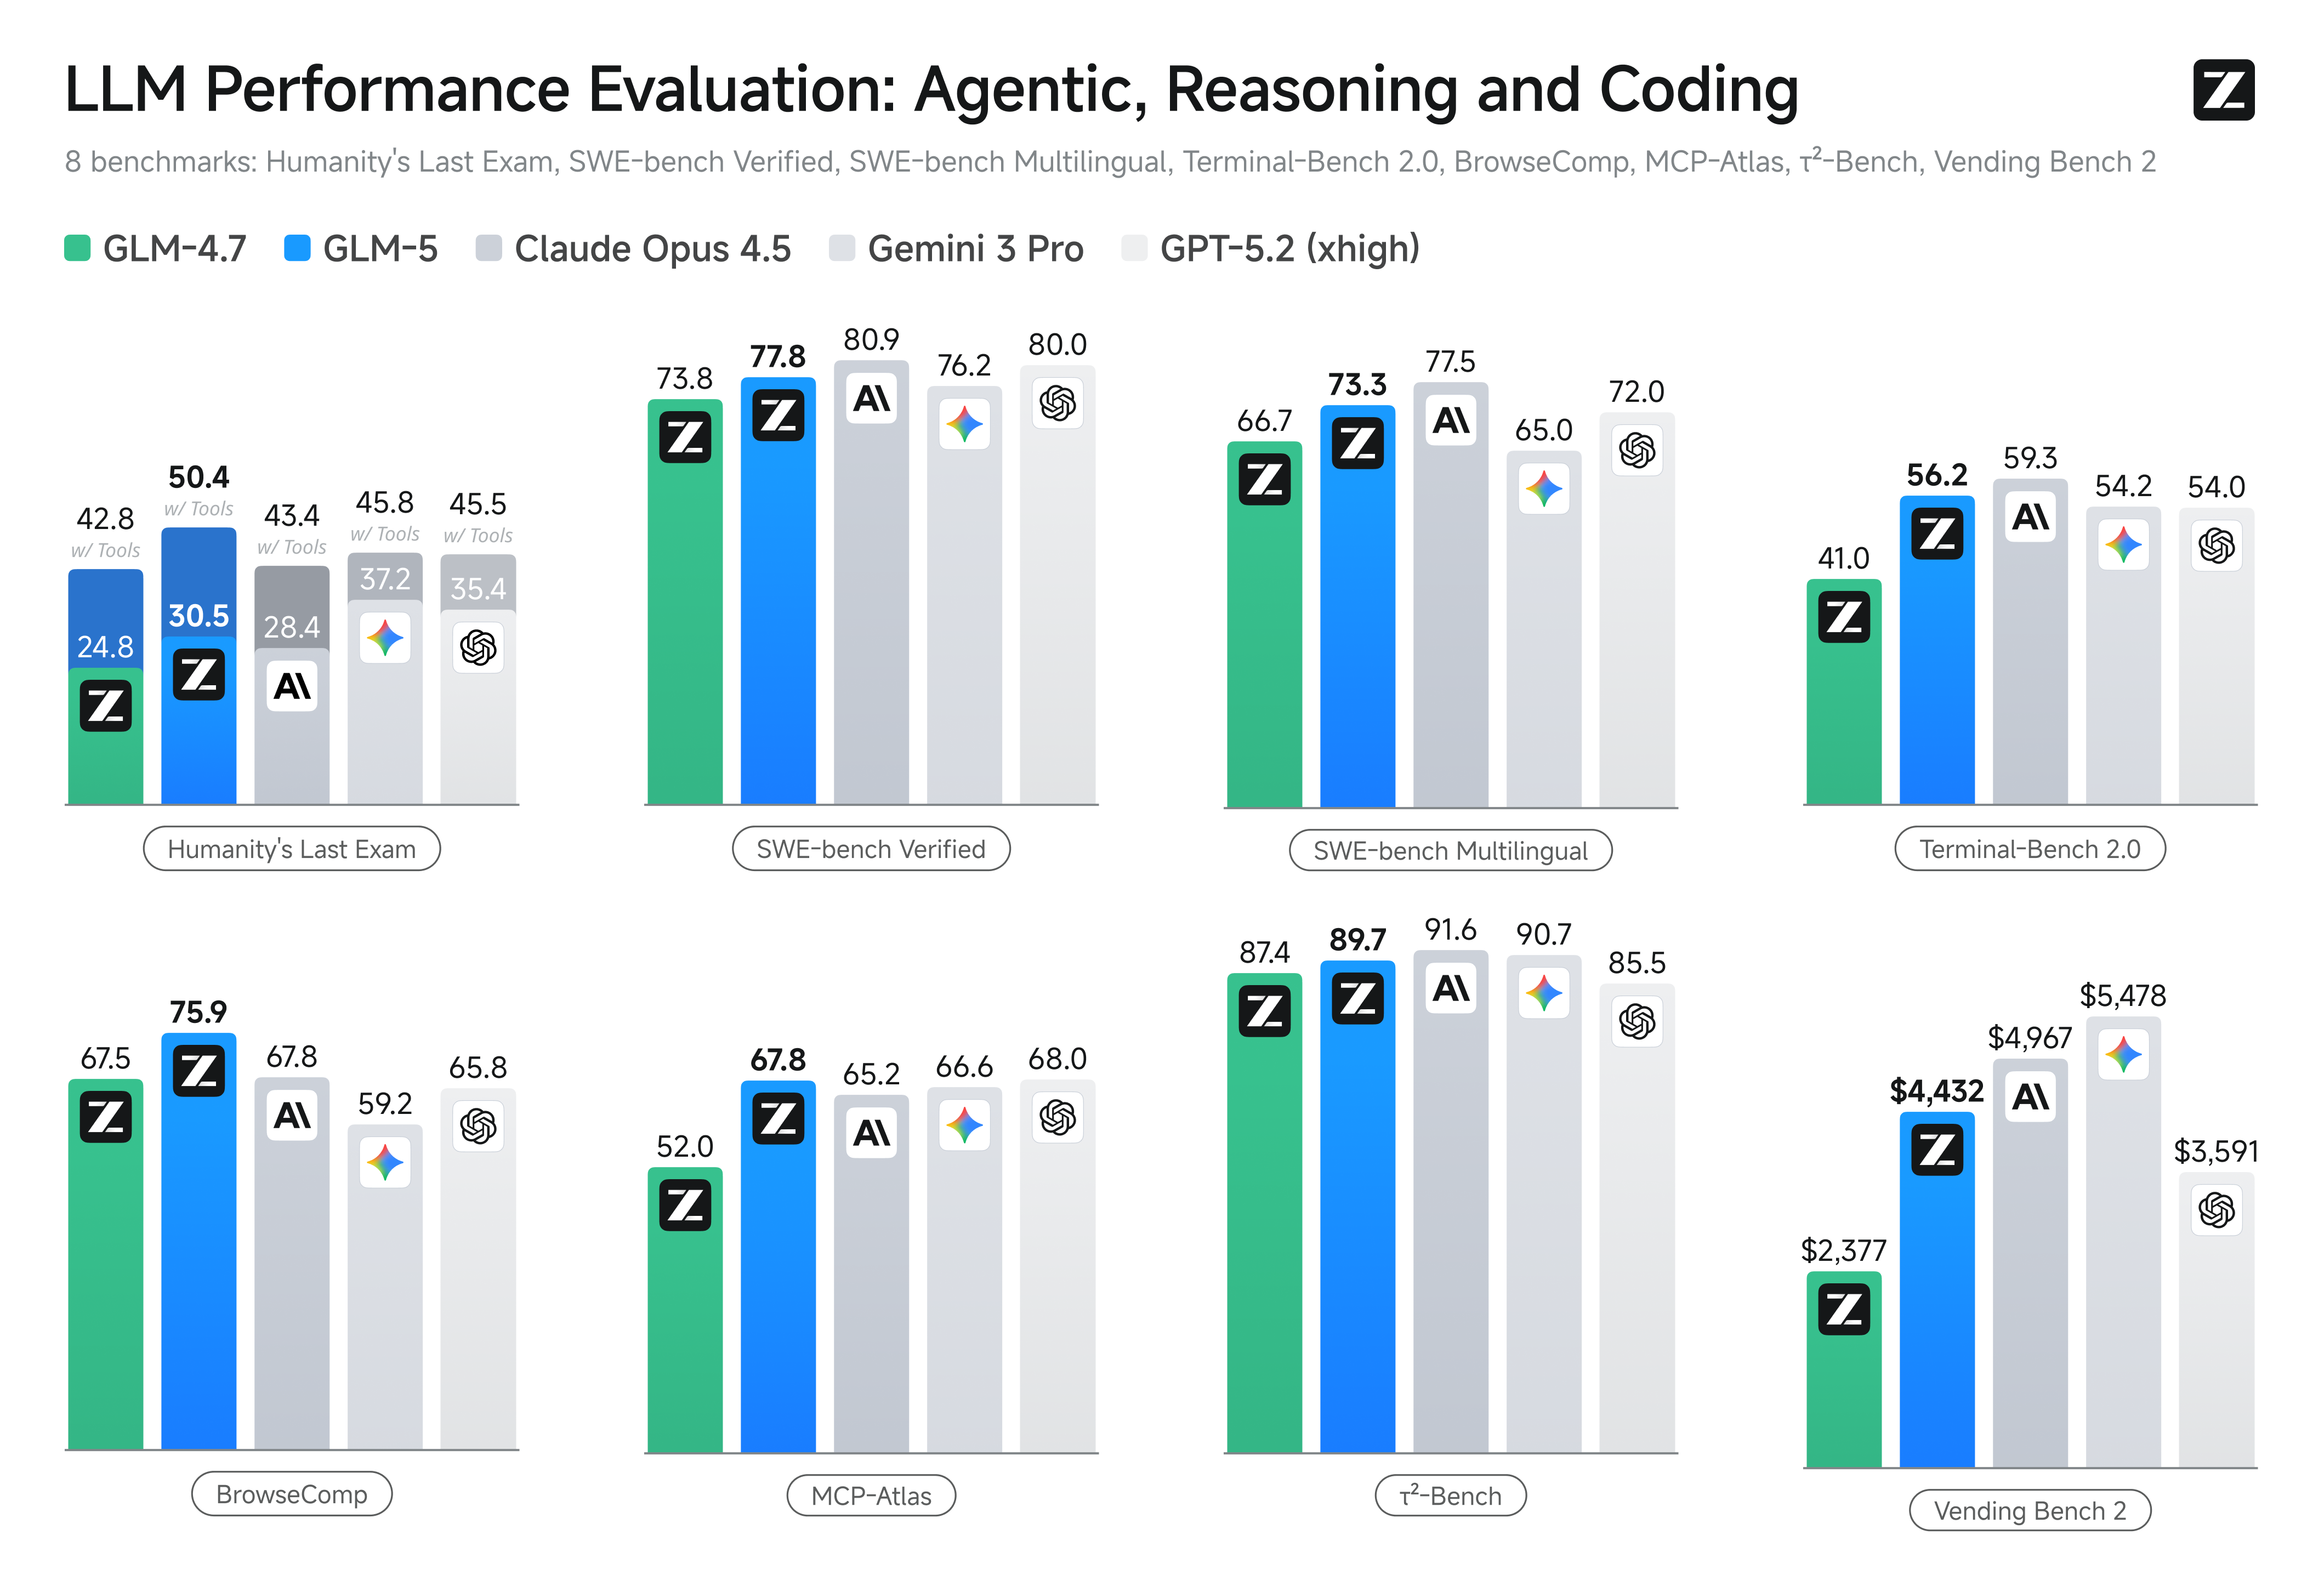
Com os avanços tanto no pré-treino quanto no pós-treino, o GLM-5 apresenta melhorias significativas em comparação ao GLM-4.7 em uma ampla variedade de benchmarks acadêmicos e atinge o melhor desempenho da categoria entre todos os modelos open-source do mundo em tarefas de raciocínio, codificação e agentes, reduzindo a lacuna em relação aos modelos de fronteira.
GlmMoeDsaConfig
classe transformers.GlmMoeDsaConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 154880hidden_size: int = 6144intermediate_size: int = 12288moe_intermediate_size: int = 2048num_hidden_layers: int = 78num_attention_heads: int = 64num_key_value_heads: int = 64n_shared_experts: int = 1n_routed_experts: int = 256output_router_logits: bool = Falserouted_scaling_factor: float = 2.5kv_lora_rank: int = 512q_lora_rank: int = 2048qk_rope_head_dim: int = 64v_head_dim: int = 256qk_nope_head_dim: int = 192n_group: int = 1topk_group: int = 1num_experts_per_tok: int = 8norm_topk_prob: bool = Truehidden_act: str = 'silu'max_position_embeddings: int = 202752initializer_range: float = 0.02rms_norm_eps: float = 1e-05use_cache: bool = Truepad_token_id: int | None = Nonebos_token_id: int | None = 0eos_token_id: int | list[int] | None = 1tie_word_embeddings: bool = Falserope_parameters: dict | None = Nonemlp_layer_types: list[str] | None = Noneattention_bias: bool = Falseattention_dropout: float | int = 0.0index_topk: int = 2048index_head_dim: int = 128index_n_heads: int = 32mlp_bias: bool = Falsehead_dim: int = 64first_k_dense_replace: int = 3layer_types: list[str] | None = Noneindexer_types: list[str] | None = None )
Parâmetros
- vocab_size (
int, opcional, padrão154880) — Tamanho do vocabulário do modelo. Define o número de tokens diferentes que podem ser representados pelosinput_ids. - hidden_size (
int, opcional, padrão6144) — Dimensão das representações ocultas. - intermediate_size (
int, opcional, padrão12288) — Dimensão das representações do MLP. - moe_intermediate_size (
int, opcional, padrão2048) — Tamanho intermediário dos MLPs dos especialistas roteados. - num_hidden_layers (
int, opcional, padrão78) — Número de camadas ocultas no decodificador do Transformer. - num_attention_heads (
int, opcional, padrão64) — Número de cabeças de atenção para cada camada de atenção no decodificador do Transformer. - num_key_value_heads (
int, opcional, padrão64) — Este é o número de cabeças de key_value que devem ser usadas para implementar Grouped Query Attention. Senum_key_value_heads=num_attention_heads, o modelo usará Multi Head Attention (MHA); senum_key_value_heads=1, o modelo usará Multi Query Attention (MQA); caso contrário, será usado GQA. Ao converter um checkpoint multi-head para um checkpoint GQA, cada cabeça de chave e valor do grupo deve ser construída por meio do meanpooling de todas as cabeças originais dentro desse grupo. Para mais detalhes, consulte este artigo. Se não for especificado, o valor padrão seránum_attention_heads. - n_shared_experts (
int, opcional, padrão1) — Número de especialistas compartilhados. - n_routed_experts (
int, opcional, padrão256) — Número de especialistas roteados. - output_router_logits (
bool, opcional, padrãoFalse) — Indica se os logits do roteador devem ser retornados pelo modelo. Ativar essa opção também permitirá que o modelo saída a perda auxiliar, incluindo a perda de balanceamento de carga e a perda z do roteador. - routed_scaling_factor (
float, opcional, padrão2.5) — Fator de escala dos especialistas roteados. - kv_lora_rank (
int, opcional, padrão512) — Rank das matrizes LoRA para as projeções de chave e valor. - q_lora_rank (
int, opcional, padrão2048) — Rank das matrizes LoRA para as projeções de query. - qk_rope_head_dim (
int, opcional, padrão64) — Dimensão dos cabeçalhos de query/key que utilizam embeddings de posição rotativa. - v_head_dim (
int, opcional, padrão256) — Dimensão dos cabeçalhos de valor. - qk_nope_head_dim (
int, opcional, padrão192) — Dimensão dos cabeçalhos de query/key que não utilizam embeddings de posição rotativa. - n_group (
int, opcional, padrão 1) — Número de grupos para especialistas roteados. - topk_group (
int, opcional, padrão1) — Número de grupos selecionados para cada token (para cada token, garantindo que os especialistas selecionados estejam apenas dentro detopk_groupgrupos). - num_experts_per_tok (
int, opcional, padrão8) — Número de especialistas para os quais cada token deve ser roteado. Este é o valor top-k para o roteamento de escolha de token. - norm_topk_prob (
bool, opcional, padrãoTrue) — Indica se as pesos dos especialistas roteados devem ser normalizados. - hidden_act (
str, opcional, padrãosilu) — A função de ativação não linear (função ou string) no decodificador. Por exemplo,"gelu","relu","silu", etc. - max_position_embeddings (
int, opcional, padrão202752) — O comprimento máximo da sequência com o qual este modelo pode ser utilizado. - initializer_range (
float, opcional, padrão0.02) — O desvio padrão do truncated_normal_initializer para inicializar todas as matrizes de pesos. - rms_norm_eps (
float, opcional, padrão1e-05) — O epsilon usado pelas camadas de normalização rms. - use_cache (
bool, opcional, padrãoTrue) — Se o modelo deve ou não retornar as últimas chaves/valores de atenção (não usado por todos os modelos). Relevante apenas seconfig.is_decoder=Trueou quando o modelo for um modelo generativo somente decodificador. - pad_token_id (
int, opcional) — ID do token usado para preenchimento no vocabulário. - bos_token_id (
int, opcional, padrão0) — ID do token usado para o início do fluxo no vocabulário. - eos_token_id (
Union[int, list[int]], opcional, padrão1) — ID do token usado para o fim do fluxo no vocabulário. - tie_word_embeddings (
bool, opcional, padrãoFalse) — Se deve vincular as embeddings de pesos de acordo com o mapeamentotied_weights_keysdo modelo. - rope_parameters (
dict, opcional) — Dicionário contendo os parâmetros de configuração para os embeddings RoPE. O dicionário deve conter um valor pararope_thetae, opcionalmente, parâmetros usados para escalonamento, caso você queira usar RoPE commax_position_embeddingsmaiores. - mlp_layer_types (
list, opcional) — Padrão de tipo de MLP para cada camada ("dense"ou"sparse"). O padrão é 3 camadas densas + o restante esparsas. - attention_bias (
bool, opcional, padrãoFalse) — Indica se deve ser usado um viés nas camadas de projeção de query, key, value e output durante a autoatenção. - attention_dropout (
Union[float, int], opcional, padrão0.0) — A taxa de dropout para as probabilidades de atenção. - index_topk (
int, opcional, padrão 2048) — Número de tokens principais selecionados pelo indexador para a atenção esparsa. - index_head_dim (
int, opcional, padrão 128) — Dimensão da cabeça para as projeções do indexador (DSA). - index_n_heads (
int, opcional, padrão 32) — Número de cabeças para as projeções do indexador (DSA). - mlp_bias (
bool, opcional, padrãoFalse) — Se deve usar um viés nas camadas up_proj, down_proj e gate_proj das camadas MLP. - head_dim (
int, opcional, padrão64) — A dimensão da cabeça de atenção. Se for None, o valor padrão será hidden_size // num_attention_heads - first_k_dense_replace (
int, opcional, padrão 3) — Número de camadas iniciais que usam um MLP denso; as demais usam o bloco MoE. - layer_types (
list[str], opcional) — Uma lista que mapeia explicitamente cada índice de camada com seu tipo de camada. Se não for fornecida, será gerada automaticamente com base nos valores de configuração. - indexer_types (
list[str], opcional) — Modo do indexer por camada ("full"executa o indexer,"shared"reutiliza o top-k da camada full anterior). O padrão padrão é derivado deindex_topk_freq/index_skip_topk_offset(ouindex_topk_pattern).
Esta é a classe de configuração para armazenar a configuração de um GlmMoeDsaModel. Ela é usada para instanciar um modelo Glm Moe Dsa de acordo com os argumentos especificados, definindo a arquitetura do modelo. Instanciar uma configuração com os padrões resultará em uma configuração semelhante à do zai-org/GLM-5
Os objetos de configuração herdam de PreTrainedConfig e podem ser usados para controlar as saídas do modelo. Consulte a documentação de PreTrainedConfig para mais informações.
>>> from transformers import GlmMoeDsaConfig, GlmMoeDsaModel

>>> # Initializing a GLM-MoE-DSA configuration
>>> configuration = GlmMoeDsaConfig()

>>> # Initializing a model from the configuration
>>> model = GlmMoeDsaModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
GlmMoeDsaModel
classe transformers.GlmMoeDsaModel
< source >( config: GlmMoeDsaConfig )
Parâmetros
- config (GlmMoeDsaConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O modelo Glm Moe Dsa puro, que gera estados ocultos brutos sem nenhum cabeçalho específico no topo.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeModelOutputWithPast or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- position_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, opcional) — Estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nopast_key_valuesretornado pelo modelo em uma etapa anterior da decodificação, quandouse_cache=Trueouconfig.use_cache=True.Apenas uma instância de Cache é permitida como entrada, consulte nosso guia de cache de kv. Se nenhum
past_key_valuesfor passado, DynamicCache será inicializado por padrão.O modelo sairá no mesmo formato de cache que é fornecido como entrada.
Se
past_key_valuesforem usados, espera-se que o usuário insira apenas osinput_idsnão processados (aqueles que não têm seus estados de chave e valor passados fornecidos a este modelo) com a forma(batch_size, unprocessed_length), em vez de todos osinput_idscom a forma(batch_size, sequence_length). - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - use_cache (
bool, opcional) — Se definido comoTrue, os estados de chave-valorpast_key_valuessão retornados e podem ser usados para acelerar a decodificação (vejapast_key_values).
Retorna
MoeModelOutputWithPast ou tuple(torch.Tensor)
Um MoeModelOutputWithPast ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos, dependendo da configuração (GlmMoeDsaConfig) e das entradas.
O método forward do GlmMoeDsaModel sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
last_hidden_state (
torch.Tensorde forma(batch_size, sequence_length, hidden_size)) — Sequência de estados ocultos na saída da última camada do modelo.past_key_values (
Cache, opcional, retornado quandouse_cache=Trueé passado ou quandoconfig.use_cache=True) — É uma instância de Cache. Para mais detalhes, consulte nosso guia de cache kv.Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e, opcionalmente, se
config.is_encoder_decoder=True, nos blocos de atenção cruzada) que podem ser usados (veja a entradapast_key_values) para acelerar a decodificação sequencial.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
router_logits (
tuple(torch.Tensor), opcional, retornado quandooutput_router_probs=Trueeconfig.add_router_probs=Truesão passados ou quandoconfig.output_router_probs=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, sequence_length, num_experts).Logits brutos do roteador (pós-softmax) calculados pelos roteadores MoE; esses termos são usados para calcular a perda auxiliar em modelos Mixture of Experts.
GlmMoeDsaForCausalLM
classe transformers.GlmMoeDsaForCausalLM
< source >( config: GlmMoeDsaConfig )
Parâmetros
- config (GlmMoeDsaConfig) — Classe de configuração do modelo com todos os parâmetros do modelo. A inicialização com um arquivo de configuração não carrega os pesos associados ao modelo, apenas a configuração. Consulte o método from_pretrained() para carregar os pesos do modelo.
O Modelo Glm Moe Dsa para modelagem de linguagem causal.
Este modelo herda de PreTrainedModel. Consulte a documentação da classe pai para os métodos genéricos que a biblioteca implementa para todos os seus modelos (como download ou salvamento, redimensionamento dos embeddings de entrada, poda de cabeças, etc.)
Este modelo também é uma subclasse de torch.nn.Module do PyTorch. Use-o como um Módulo PyTorch regular e consulte a documentação do PyTorch para todos os assuntos relacionados ao uso geral e ao comportamento.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeCausalLMOutputWithPast or tuple(torch.Tensor)
Parâmetros
- input_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices dos tokens da sequência de entrada no vocabulário. O padding será ignorado por padrão.Os índices podem ser obtidos usando AutoTokenizer. Consulte PreTrainedTokenizer.encode() e PreTrainedTokenizer.call() para mais detalhes.
- attention_mask (
torch.Tensorde forma(batch_size, sequence_length), opcional) — Máscara para evitar a execução de atenção nos índices de tokens de preenchimento. Valores de máscara selecionados em[0, 1]:- 1 para tokens que não estão mascarados,
- 0 para tokens que estão mascarados.
- position_ids (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Índices das posições dos tokens de cada sequência de entrada nos embeddings de posição. Selecionados no intervalo[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, opcional) — Estados ocultos pré-computados (chaves e valores nos blocos de autoatenção e nos blocos de atenção cruzada) que podem ser usados para acelerar a decodificação sequencial. Isso geralmente consiste nopast_key_valuesretornado pelo modelo em uma etapa anterior da decodificação, quandouse_cache=Trueouconfig.use_cache=True.Apenas uma instância de Cache é permitida como entrada, consulte nosso guia de cache de kv. Se nenhum
past_key_valuesfor passado, DynamicCache será inicializado por padrão.O modelo sairá no mesmo formato de cache que é fornecido como entrada.
Se
past_key_valuesforem usados, espera-se que o usuário insira apenas osinput_idsnão processados (aqueles que não têm seus estados de chave e valor passados fornecidos a este modelo) com a forma(batch_size, unprocessed_length), em vez de todos osinput_idscom a forma(batch_size, sequence_length). - inputs_embeds (
torch.Tensorde forma(batch_size, sequence_length, hidden_size), opcional) — Opcionalmente, em vez de passarinput_ids, você pode escolher passar diretamente uma representação incorporada. Isso é útil se você quiser ter mais controle sobre como converter os índices deinput_idsnos vetores associados do que a matriz de busca de incorporação interna do modelo. - labels (
torch.LongTensorde forma(batch_size, sequence_length), opcional) — Rótulos para calcular a perda de modelagem de linguagem causal. Os índices devem estar em[-100, 0, ..., config.vocab_size](vejainput_idsdocstring). Tokens com índices definidos como-100são ignorados (mascarados), a perda é calculada apenas para os tokens com rótulos em[0, ..., config.vocab_size].Os rótulos são deslocados internamente para que
labels[..., 1:]sejam usados para preverlogits[..., :-1, :]. Passe rótulos não deslocados que correspondam ainput_ids(ou seja,labels = input_ids). Não desloque os rótulos você mesmo antes de passá-los.Se os rótulos já estiverem deslocados (por exemplo, com paralelismo de sequência), passe-os como o argumento de palavra-chave
shift_labelse eles serão usados como estão.labelsainda deve ser passado para que a perda seja calculada. - use_cache (
bool, opcional) — Se definido comoTrue, os estados de chave-valorpast_key_valuessão retornados e podem ser usados para acelerar a decodificação (vejapast_key_values). - logits_to_keep (
Union[int, torch.Tensor], opcional, padrão0) — Se for umint, calcula os logits para os últimoslogits_to_keeptokens. Se for0, calcula os logits para todos osinput_ids(caso especial). Apenas os logits do último token são necessários para a geração, e calculá-los apenas para esse token pode economizar memória, o que se torna bastante significativo para sequências longas ou tamanho de vocabulário grande. Se for umtorch.Tensor, deve ser 1D, correspondendo aos índices a serem mantidos na dimensão de comprimento da sequência. Isso é útil ao usar o formato de tensor empacotado (uma única dimensão para lote e comprimento da sequência).
Retorna
MoeCausalLMOutputWithPast ou tuple(torch.Tensor)
Um MoeCausalLMOutputWithPast ou uma tupla de
torch.Tensor (se return_dict=False for passado ou quando config.return_dict=False) contendo vários
elementos dependendo da configuração (GlmMoeDsaConfig) e das entradas.
O método forward de GlmMoeDsaForCausalLM sobrescreve o método especial __call__.
Embora a receita para a passagem direta precise ser definida dentro desta função, deve-se chamar a instância de
Moduleem seguida, em vez desta, pois a primeira cuida da execução das etapas de pré e pós-processamento, enquanto a segunda as ignora silenciosamente.
loss (
torch.Tensorde forma(1,), opcional, retornado quandolabelsé fornecido) — Perda de modelagem de linguagem (para previsão do próximo token).logits (
torch.Tensorde forma(batch_size, sequence_length, config.vocab_size)) — Pontuações de previsão da cabeça de modelagem de linguagem (pontuações para cada token do vocabulário antes do SoftMax).aux_loss (
torch.Tensor, opcional, retornado quandooutput_router_logits=Trueé passado ou quandoconfig.output_router_logits=True, e o modelo treina seu roteador com uma perda de balanceamento de carga) — Perda auxiliar de balanceamento de carga para os módulos esparsos. Modelos que equilibram seus especialistas com um viés de roteador em vez disso (DeepSeek-V3 e as arquiteturas derivadas dele) retornamNoneaqui, mas ainda retornamrouter_logits.router_logits (
tuple(torch.Tensor), opcional, retornado quandooutput_router_logits=Trueé passado ou quandoconfig.output_router_logits=True) — Tupla detorch.Tensor(um para cada camada esparsa) com forma(batch_size * sequence_length, num_experts).Logits brutos do roteador calculados pelos roteadores MoE. Podem ser usados para calcular uma perda de balanceamento de carga ou para inspecionar como os tokens são distribuídos entre os especialistas.
past_key_values (
Cache, opcional, retornado quandouse_cache=Trueé passado ou quandoconfig.use_cache=True) — É uma instância de Cache. Para mais detalhes, consulte nosso guia de cache kv.Contém estados ocultos pré-computados (chaves e valores nos blocos de autoatenção) que podem ser usados (veja a entrada
past_key_values) para acelerar a decodificação sequencial.hidden_states (
tuple(torch.Tensor), opcional, retornado quandooutput_hidden_states=Trueé passado ou quandoconfig.output_hidden_states=True) — Tupla detorch.Tensor(um para a saída dos embeddings, se o modelo tiver uma camada de embedding, + um para a saída de cada camada) de forma(batch_size, sequence_length, hidden_size).Estados ocultos do modelo na saída de cada camada, além das saídas opcionais do embedding inicial.
attentions (
tuple(torch.Tensor), opcional, retornado quandooutput_attentions=Trueé passado ou quandoconfig.output_attentions=True) — Tupla detorch.Tensor(um para cada camada) com forma(batch_size, num_heads, sequence_length, sequence_length).Pesos de atenção após o softmax de atenção, usados para calcular a média ponderada nos cabeçalhos de autoatenção.
Exemplo:
>>> from transformers import AutoTokenizer, GlmMoeDsaForCausalLM

>>> model = GlmMoeDsaForCausalLM.from_pretrained("meta-glm_moe_dsa/GlmMoeDsa-2-7b-hf")
>>> tokenizer = AutoTokenizer.from_pretrained("meta-glm_moe_dsa/GlmMoeDsa-2-7b-hf")

>>> prompt = "Hey, are you conscious? Can you talk to me?"
>>> inputs = tokenizer(prompt, return_tensors="pt")

>>> # Generate
>>> generate_ids = model.generate(inputs.input_ids, max_length=30)
>>> tokenizer.batch_decode(generate_ids, skip_special_tokens=True, clean_up_tokenization_spaces=False)[0]
"Hey, are you conscious? Can you talk to me?\nI'm not conscious, but I can talk to you."