
PEFT documentation
BOFT
BOFT
Orthogonal Butterfly (BOFT)は、基盤モデルのファインチューニングのために設計された汎用的な手法です。Cooley-Tukey高速フーリエ変換から着想を得て、ファインチューニングのパラダイムであるOrthogonal Finetuning (OFT)のパラメータ効率を向上させます。大規模ビジョントランスフォーマー、大規模言語モデル、テキストから画像への拡散モデルを含む、さまざまな基盤モデルのファインチューニングにおいて、良好な結果を示しています。
論文の抄録は以下の通りです:
大規模な基盤モデルは広く普及しつつありますが、ゼロからそれらを訓練することは非常に高コストです。そのため、これらの強力なモデルを効率的に下流タスクへ適応させることがますます重要になっています。本論文では、下流タスク適応のための原理的なファインチューニングパラダイムである直交ファインチューニング(OFT)を研究します。OFTは優れた汎化能力を示すものの、直交行列の高次元性により、依然として相当数の学習可能パラメータを必要とします。これを解決するため、まず情報伝達の観点からOFTを考察し、より高いパラメータ効率を可能にするいくつかの重要な要件を特定しました。Cooley-Tukey高速フーリエ変換アルゴリズムが効率的な情報伝達を可能にする仕組みに着想を得て、バタフライ構造を用いた効率的な直交パラメータ化を提案します。このパラメータ化をOFTに適用することで、直交バタフライ(BOFT)と呼ばれる新しいパラメータ効率の良いファインチューニング手法を創出しました。OFTを特殊ケースとして包含することで、BOFTは汎用的な直交ファインチューニングフレームワークを導入します。最後に、大規模ビジョントランスフォーマー、大規模言語モデル、テキストから画像への拡散モデルを、ビジョンおよび言語のさまざまな下流タスクへ適応させる広範な実証研究を実施しました。
BOFTは、事前学習済みモデルの生成能力を維持しつつ、標準的なOFTよりもはるかにパラメータ効率が高いことを目指しています。OFTと同様に、BOFTは事前学習済み重み行列に直交変換を適用することで、層内のすべてのニューロン間のペアごとのコサイン類似度(超球面エネルギー)を維持し、ニューロン間の意味的関係が保持されることを保証します。
ブロック対角直交行列を使用する代わりに、BOFTは直交変換をスパースバタフライ行列の積に因数分解します(Cooley–Tukey FFTで最初に導入されたもの)。ブロック対角回転を行うOFTとは異なり、バタフライ構造は各ブロック内の入力のみを混合するのではなく、すべての入力がすべての出力に影響を与えることを保証します。これにより、O(d log d)のパラメータ数だけで密結合が実現されます。この因数分解は、計算時間の増加を代償とすることで、OFTと比較してパラメータ数を大幅に削減しながらも表現力を維持します。
実際には、BOFTは事前学習済み重み行列をバタフライ構造の直交因子の列で乗算することで、効率的かつ表現力豊かなニューロン回転を可能にします。これにより、BOFTは制御可能な生成や、事前学習済みモデルの主題表現を維持することが重要なタスクに適しており、さらにメモリと計算のオーバーヘッドを低減しながら、より大きなモデルにもスケーリングできます。
BOFTは、ニューラルネットワーク内の重み行列の任意の部分集合に適用でき、学習可能なパラメータ数を削減できます。BOFTパラメータを注入する対象レイヤーが与えられた場合、重み行列のサイズに基づいて学習可能なパラメータ数を決定できます。
ベンチマーク概要
BOFTの重みをベースモデルにマージする
LoRAと同様に、BOFTで学習された重みは、~BOFTModel.merge_and_unload()関数を使用して事前学習済み重み行列に統合できます。この関数はアダプタの重みをベースモデルとマージするため、マージ後の新しいモデルを単独のモデルとして効果的に利用できます。
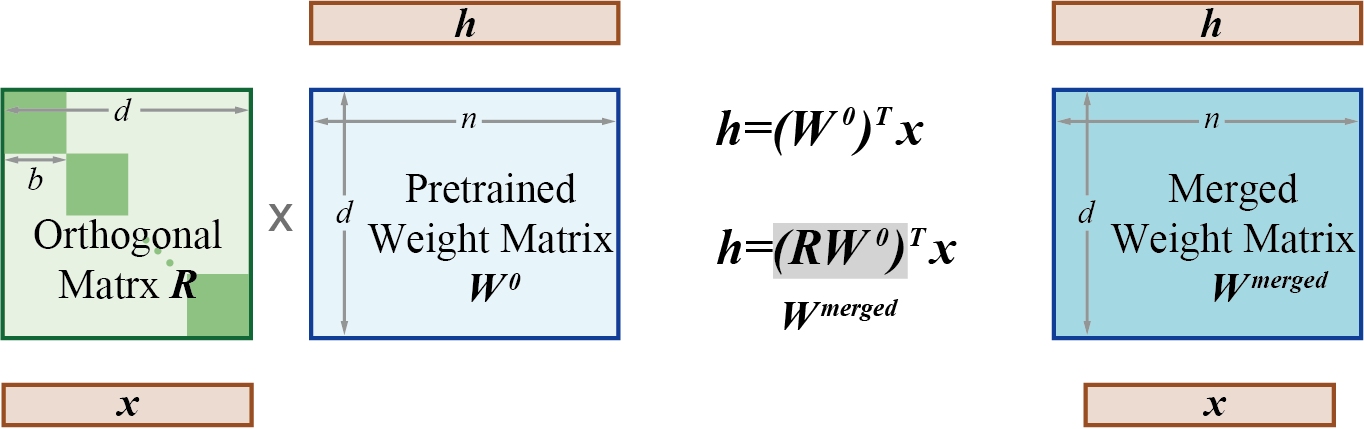
これは、学習中に直交行列(上記の図のR)と事前学習済み重み行列が別々に扱われるため、このように動作します。学習が完了すると、これらの重みは実際には乗算によって結合され、等価な新しい重み行列を生成できます。
BOFTの使用例
BOFT手法をさまざまな下流タスクに適用する例については、以下のガイドを参照してください。
BOFTでモデルをファインチューニングする方法について、以下のステップバイステップのガイドをご覧ください:
画像分類タスクでは、DinoV2モデルのBOFT設定を次のように初期化できます。
import transformers
from transformers import AutoModelForSeq2SeqLM, BOFTConfig
from peft import BOFTConfig, get_peft_model

config = BOFTConfig(
    boft_block_size=4,
    boft_n_butterfly_factor=2,
    target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
    boft_dropout=0.1,
    bias="boft_only",
    modules_to_save=["classifier"],
)

model = transformers.Dinov2ForImageClassification.from_pretrained(
    "facebook/dinov2-large",
    num_labels=100,
)

boft_model = get_peft_model(model, config)
API
BOFTConfig
クラス peft.BOFTConfig
< source >( task_type: Optional[Union[str, TaskType]] = Nonepeft_type: Optional[Union[str, PeftType]] = Noneauto_mapping: Optional[dict] = Nonepeft_version: Optional[str] = Nonebase_model_name_or_path: Optional[str] = Nonerevision: Optional[str] = Noneinference_mode: bool = Falseboft_block_size: int = 4boft_block_num: int = 0boft_n_butterfly_factor: int = 1target_modules: Optional[Union[list[str], str]] = Noneexclude_modules: Optional[Union[list[str], str]] = Noneboft_dropout: float = 0.0fan_in_fan_out: bool = Falsebias: str = 'none'modules_to_save: Optional[list[str]] = Noneinit_weights: bool = Truelayers_to_transform: Optional[Union[list[int], int]] = Nonelayers_pattern: Optional[Union[list[str], str]] = None )
パラメータ
- boft_block_size (
int) — 異なるレイヤー間の BOFT マトリックスのブロックサイズをintで表したものです。ブロックサイズを大きくすると、学習可能なパラメータ数が増えるより密な更新マトリックスになります。boft_block_sizeは、ほとんどのレイヤーの入力次元(in_features)で割り切れる値、例えば 4、8、16 などを指定してください。また、boft_block_sizeまたはboft_block_numのいずれか一方のみを指定し、両方を同時に指定したり、両方を 0 にしたりしないでください。boft_block_sizexboft_block_numはレイヤーの入力次元と等しくなる必要があるためです。 - boft_block_num (
int) — 注入される各レイヤーあたりの BOFT ブロックの数。boft_block_numが大きいほど、更新行列はスパースになり、学習可能なパラメータの数は少なくなります。注意、boft_block_numは、ほとんどのレイヤーの入力次元 (in_features) で割り切れる値、例えば 4、8、16 などを指定してください。boft_block_sizeとboft_block_numは同時に指定せず、また両方を 0 にしないようにしてください。これは、boft_block_sizexboft_block_numがレイヤーの入力次元と等しくなる必要があるためです。 - boft_n_butterfly_factor (
int) — 異なるレイヤーにわたるバタフライ係数の数。boft_n_butterfly_factor=1の場合、BOFTはバニラのOFTと同じであり、boft_n_butterfly_factor=2の場合、OFTの有効なブロックサイズは2倍になり、ブロック数は半分になります。 - target_modules (
Union[List[str],str]) — アダプターを適用するモジュールの名前。 - exclude_modules (
Optional[Union[List[str], str]]) — アダプタを適用しないモジュールの名前。文字列を渡す場合、正規表現によるマッチングが行われます。文字列のリストを渡す場合、完全一致が行われるか、モジュール名が渡された文字列のいずれかで終わるかがチェックされます。 - boft_dropout (
float) — LoRAのdropout層と同様に、学習中にOFTブロックを恒等変換に設定することで、乗算dropoutの確率を指定します。 - fan_in_fan_out (
bool) — 置き換えるレイヤーが重みを (fan_in, fan_out) の形式で保存している場合は、これを True に設定してください。 例えば、gpt-2 は重みを (fan_in, fan_out) の形式で保存するConv1Dを使用しているため、これをTrueに設定する必要があります。 - bias (
str) — BOFT のバイアスタイプ。‘none’、‘all’、‘boft_only’ のいずれかを指定できます。‘all’ または ‘boft_only’ を指定した場合、対応するバイアスが学習中に更新されます。この設定により、アダプターを無効にしても、適応なしのベースモデルが生成する出力と同一の結果は得られない点にご注意ください。 - modules_to_save (
List[str]) — BOFTレイヤー以外で、学習可能に設定し、最終的なチェックポイントに保存するモジュールのリスト - layers_to_transform (
Union[List[int],int]) — 変換対象のレイヤーのインデックスです。この引数が指定されている場合、このリストに指定されたレイヤーのインデックスに対して BOFT 変換が適用されます。単一の整数が渡された場合、そのインデックスのレイヤーに対して BOFT 変換が適用されます。 - layers_pattern (
Optional[Union[List[str], str]]) —layers_to_transformがNoneと異なり、かつレイヤーパターンが共通のレイヤーパターンに含まれない場合にのみ使用される、レイヤーパターンの名前です。これはモデルのnn.ModuleListを対象とすべきであり、通常は'layers'または'h'と呼ばれます。
これはBOFTModelの設定を保存するための設定クラスです。
BOFTModel
クラス peft.BOFTModel
< source >( modelpeft_config: Union[PeftConfig, dict[str, PeftConfig]]adapter_name: strlow_cpu_mem_usage: bool = Falsestate_dict: Optional[dict[str, torch.Tensor]] = None ) → torch.nn.Module
パラメータ
- model (transformers.PreTrainedModel) — 適応させる対象のモデル。
- config (BOFTConfig) — BOFTモデルの設定。
- adapter_name (
str) — アダプターの名前。デフォルトは"default"です。 - low_cpu_mem_usage (
bool、optional、デフォルトはFalse) — メタデバイス上に空のアダプター重みを生成します。読み込みプロセスを高速化するために有用です。
戻り値
torch.nn.Module
BOFTモデル。
事前学習済みのTransformersモデルからBOFTおよびOFTモデルを作成します。論文: https://huggingface.co/papers/2311.06243 https://huggingface.co/papers/2306.07280
例:
>>> import transformers
>>> from peft import BOFTConfig, get_peft_model

>>> config = BOFTConfig(
...     boft_block_size=8,
...     boft_n_butterfly_factor=1,
...     target_modules=["query", "value", "key", "output.dense", "mlp.fc1", "mlp.fc2"],
...     boft_dropout=0.1,
...     bias="boft_only",
...     modules_to_save=["classifier"],
... )

>>> model = transformers.Dinov2ForImageClassification.from_pretrained(
...     "facebook/dinov2-large",
...     num_labels=100,
... )
>>> boft_model = get_peft_model(model, config)属性:
- model (transformers.PreTrainedModel) — 適応させる対象のモデル。
- peft_config (BOFTConfig): BOFTモデルの設定です。