# YOSO
## 概述
YOSO 模型由 Zhanpeng Zeng、Yunyang Xiong、Sathya N. Ravi、Shailesh Acharya、Glenn Fung 和 Vikas Singh 在 [You Only Sample (Almost) Once: Linear Cost Self-Attention Via Bernoulli Sampling](https://huggingface.co/papers/2111.09714) 中提出。YOSO 通过基于局部敏感哈希(LSH)的伯努利采样方案来近似标准的 softmax 自注意力。原则上,所有伯努利随机变量都可以通过单次哈希进行采样。
该论文的摘要如下:
*基于 Transformer 的模型在自然语言处理(NLP)中被广泛使用。Transformer 模型的核心是自注意力机制,它捕获输入序列中 token 对之间的交互,并且其复杂度随序列长度呈二次方增长。在更长的序列上训练此类模型代价高昂。在本文中,我们展示了一种基于局部敏感哈希(LSH)的伯努利采样注意力机制,可将此类模型的二次方复杂度降低为线性。我们将自注意力视为与伯努利随机变量相关联的单个 token 之和,从而绕过了二次方开销;原则上,这些随机变量可以通过单次哈希一次性采样(尽管在实践中,该数量可能是一个较小的常数)。这带来了一种高效的采样方案,用于估计自注意力,该方案依赖于对 LSH 的特定修改(以便在 GPU 架构上部署)。我们在标准 512 序列长度的 GLUE 基准上评估了我们的算法,结果显示其性能优于标准的预训练 Transformer。在用于评估长序列性能的 Long Range Arena (LRA) 基准上,我们的方法取得了与 softmax 自注意力一致的结果,但具有显著的速度提升和内存节省,并且通常优于其他高效的自注意力方法。我们的代码位于此 https URL*
该模型由 [novice03](https://huggingface.co/novice03) 贡献。原始代码可在[此处](https://github.com/mlpen/YOSO)找到。
## 使用技巧
- YOSO 注意力算法通过自定义 CUDA 内核实现,这些内核是用 CUDA C++ 编写的函数,可以多次执行
在 GPU 上并行运行。
- 这些内核提供了一个`fast_hash`函数,该函数使用快速哈达玛变换来近似查询和键的随机投影。使用这些
哈希码,`lsh_cumulation` 函数通过基于 LSH 的伯努利采样来近似自注意力。
- 要使用自定义内核,用户应设置 `config.use_expectation = False`。为确保内核成功编译,
用户必须安装正确版本的 PyTorch 和 cudatoolkit。默认情况下,`config.use_expectation = True`,这将使用 YOSO-E,并且不需要编译 CUDA 内核。
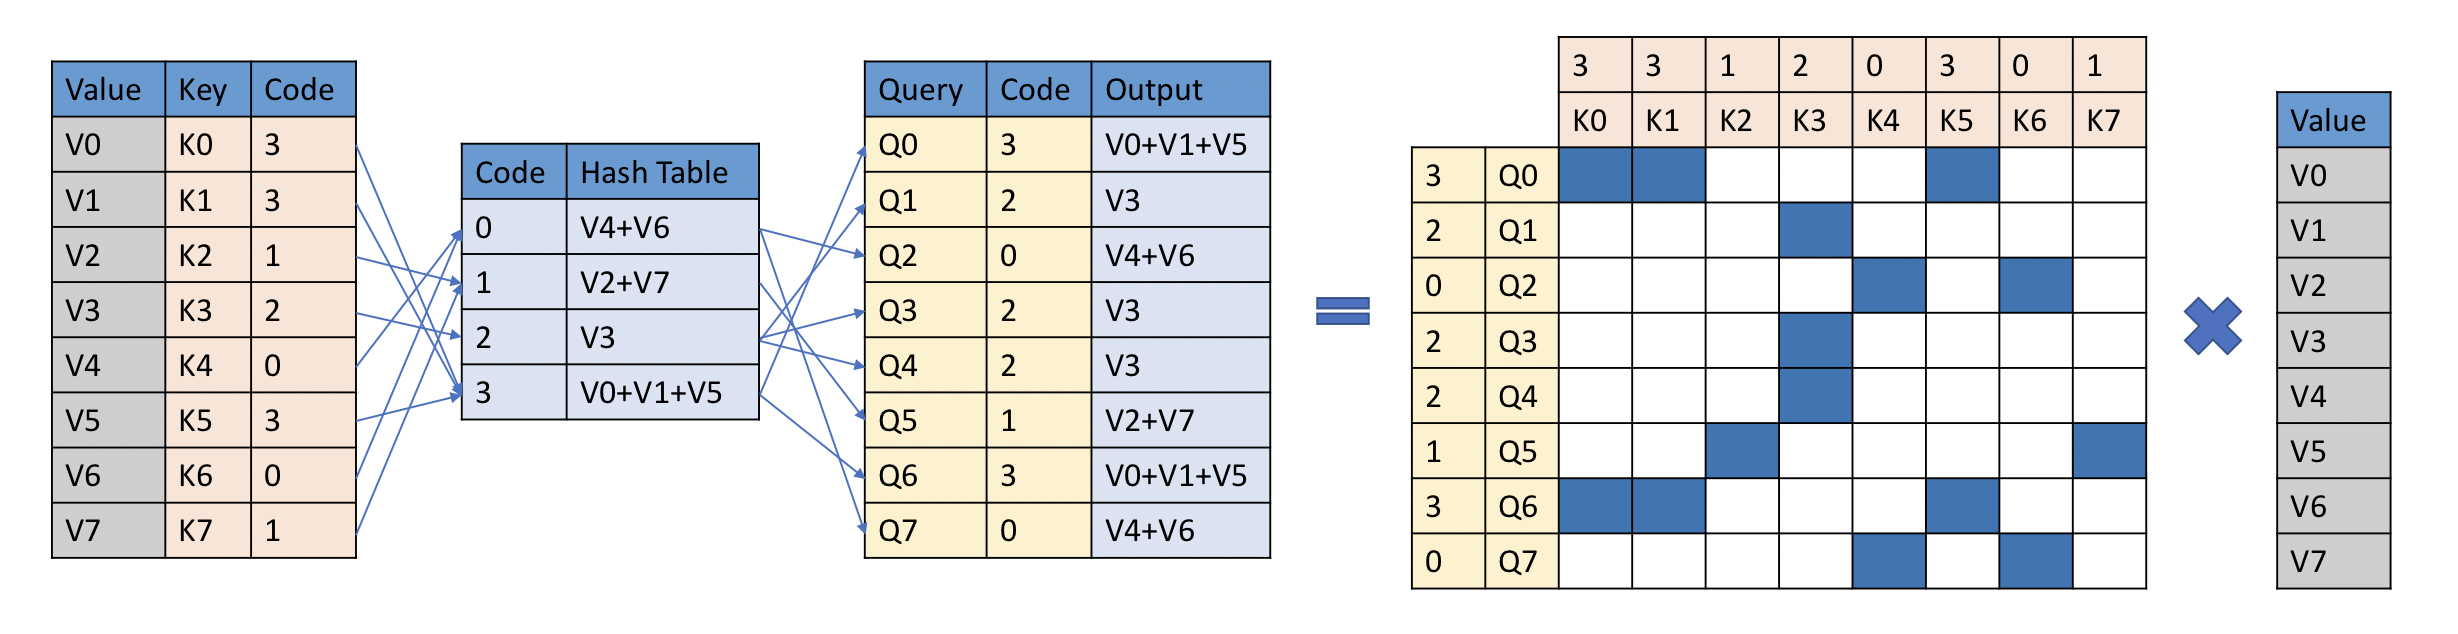 YOSO 注意力算法。摘自原始论文。
## 资源
- [文本分类任务指南](../tasks/sequence_classification)
- [Token 分类任务指南](../tasks/token_classification)
- [问答任务指南](../tasks/question_answering)
- [掩码语言建模任务指南](../tasks/masked_language_modeling)
- [多项选择任务指南](../tasks/multiple_choice)
## YosoConfig[[transformers.YosoConfig]]
#### transformers.YosoConfig[[transformers.YosoConfig]]
```python
transformers.YosoConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 50265, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 4096, type_vocab_size: int = 1, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, use_expectation: bool = True, hash_code_len: int = 9, num_hash: int = 64, conv_window: int | None = None, use_fast_hash: bool = True, lsh_backward: bool = True, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, add_cross_attention: bool = False, tie_word_embeddings: bool = True)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/configuration_yoso.py#L24)
**参数:**
vocab_size (`int`,*可选*,默认为 `50265`):模型的词汇表大小。定义了 `input_ids` 可以表示的不同 token 数量。
hidden_size (`int`,*可选*,默认为 `768`):隐藏表示的维度。
num_hidden_layers (`int`,*可选*,默认为 `12`):Transformer 解码器中的隐藏层数。
num_attention_heads (`int`,*可选*,默认为 `12`):Transformer 解码器中每个注意力层的注意力头数量。
intermediate_size (`int`,*可选*,默认值为 `3072`):MLP 表示的维度。
hidden_act (`str`,*可选*,默认为 `gelu`):解码器中的非线性激活函数(函数或字符串)。例如,`"gelu"`、`"relu"`、`"silu"` 等。
hidden_dropout_prob (`Union[float, int]`,*可选*,默认值为 `0.1`):嵌入层、编码器和池化器中所有全连接层的 dropout 概率。
attention_probs_dropout_prob (`Union[float, int]`,*可选*,默认值为 `0.1`):注意力概率的 dropout 比率。
max_position_embeddings (`int`,*可选*,默认值为 `4096`):该模型可能使用的最大序列长度。
type_vocab_size (`int`,*可选*,默认为 `1`):`token_type_ids` 的词汇表大小。
initializer_range (`float`,*可选*,默认值为 `0.02`):用于初始化所有权重矩阵的 truncated_normal_initializer 的标准差。
layer_norm_eps (`float`, *可选*,默认为 `1e-12`):层归一化层所使用的 epsilon。
use_expectation (`bool`,*可选*,默认为 `True`):是否使用 YOSO Expectation。会覆盖 num_hash 的任何影响。
hash_code_len (`int`,*可选*,默认为 9):哈希函数生成的哈希值的长度。
num_hash (`int`,*可选*,默认为 64):在 `YosoSelfAttention` 中使用的哈希函数数量。
conv_window (`int`, *可选*) : 深度可分离卷积的卷积核大小。
use_fast_hash (`bool`, *可选*, 默认为 `False`) : 是否使用自定义的 cuda 内核,通过 hadamard 变换执行快速随机投影。
lsh_backward (`bool`, *可选*, 默认为 `True`) : 是否使用局部敏感哈希(Locality Sensitive Hashing)执行反向传播。
pad_token_id (`int`,*可选*,默认为 `1`):词表中用于填充的 token id。
bos_token_id (`int`,*可选*,默认为 `0`):词汇表中用于表示流开始的 token id。
eos_token_id (`Union[int, list[int]]`,*可选*,默认为 `2`):词汇表中用于表示流结束(end-of-stream)的 token id。
add_cross_attention (`bool`,*可选*,默认为 `False`):是否应在模型中添加交叉注意力层。
tie_word_embeddings (`bool`,*可选*,默认为 `True`):是否根据模型的 `tied_weights_keys` 映射来绑定权重嵌入。
这是用于存储 YosoModel 配置的类。它根据指定的参数实例化 Yoso 模型,并定义模型架构。使用默认值实例化配置将生成与 [uw-madison/yoso-4096](https://huggingface.co/uw-madison/yoso-4096) 类似的配置。
配置对象继承自 [PreTrainedConfig](/docs/transformers/v5.23.0/zh/main_classes/configuration#transformers.PreTrainedConfig),可用于控制模型输出。有关更多信息,请参阅 [PreTrainedConfig](/docs/transformers/v5.23.0/zh/main_classes/configuration#transformers.PreTrainedConfig) 的文档。
示例:
```python
>>> from transformers import YosoConfig, YosoModel
>>> # Initializing a YOSO uw-madison/yoso-4096 style configuration
>>> configuration = YosoConfig()
>>> # Initializing a model (with random weights) from the uw-madison/yoso-4096 style configuration
>>> model = YosoModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## YosoModel[[transformers.YosoModel]]
#### transformers.YosoModel[[transformers.YosoModel]]
```python
transformers.YosoModel(config: YosoConfig)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L616)
**参数:**
config ([YosoConfig](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoConfig)):模型配置类,包含模型的所有参数。通过配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
未添加任何特定头部的裸 Yoso 模型,直接输出原始隐藏状态。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.YosoModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L633)
**参数:**
input_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中各个 token 在词汇表中的索引。默认情况下,填充(padding)会被忽略。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取这些索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
token_type_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于指示输入中第一和第二部分的段标记索引。索引取自 `[0, 1]`: - 0 对应 *句子 A* 的标记, - 1 对应 *句子 B* 的标记。 [什么是标记类型 ID?](../glossary#token-type-ids)
position_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中每个 token 在位置嵌入中的位置索引。取值范围为 `[0, config.n_positions - 1]`。[什么是位置 ID?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`,形状为 `(batch_size, sequence_length, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `input_ids`。如果你希望比模型内部的嵌入查找矩阵更精细地控制如何将 `input_ids` 索引转换为对应的向量,这将非常有用。
output_attentions (`bool`, *可选*) : 是否返回所有注意力层的注意力张量。有关更多详细信息,请参阅返回张量中的 `attentions`。
output_hidden_states (`bool`, *可选*) : 是否返回所有层的隐藏状态。有关更多详细信息,请参阅返回张量中的 `hidden_states`。
return_dict (`bool`, *可选*) : 是否返回 [ModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.utils.ModelOutput) 而不是普通元组。
**返回:** [BaseModelOutputWithCrossAttentions](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithCrossAttentions) 或 `tuple(torch.Tensor)`
一个 [BaseModelOutputWithCrossAttentions](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithCrossAttentions) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([YosoConfig](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoConfig))和输入。
[YosoModel](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoModel) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **last_hidden_state**(形状为 `(batch_size, sequence_length, hidden_size)` 的 `torch.Tensor`)-- 模型最后一层输出的隐藏状态序列。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
- **cross_attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 且 `config.add_cross_attention=True`,或当 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
解码器交叉注意力层在注意力 softmax 之后的注意力权重,用于在交叉注意力头中计算加权平均值。
## YosoForMaskedLM[[transformers.YosoForMaskedLM]]
#### transformers.YosoForMaskedLM[[transformers.YosoForMaskedLM]]
```python
transformers.YosoForMaskedLM(config: YosoConfig)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L703)
**参数:**
config ([YosoConfig](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoConfig)):模型配置类,包含模型的所有参数。通过配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
带有`language modeling`头的 Yoso 模型。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.YosoForMaskedLM.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L725)
**参数:**
input_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中各个 token 在词汇表中的索引。默认情况下,填充(padding)会被忽略。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取这些索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
token_type_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于指示输入中第一和第二部分的段标记索引。索引取自 `[0, 1]`: - 0 对应 *句子 A* 的标记, - 1 对应 *句子 B* 的标记。 [什么是标记类型 ID?](../glossary#token-type-ids)
position_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中每个 token 在位置嵌入中的位置索引。取值范围为 `[0, config.n_positions - 1]`。[什么是位置 ID?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`,形状为 `(batch_size, sequence_length, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `input_ids`。如果你希望比模型内部的嵌入查找矩阵更精细地控制如何将 `input_ids` 索引转换为对应的向量,这将非常有用。
labels (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于计算掩码语言建模损失的标签。索引应在 `[-100, 0, ..., config.vocab_size]` 范围内(参见 `input_ids` 的文档字符串)。索引设置为 `-100` 的令牌将被忽略(掩码),损失仅针对标签在 `[0, ..., config.vocab_size]` 范围内的令牌进行计算。
output_attentions (`bool`, *可选*) : 是否返回所有注意力层的注意力张量。有关更多详细信息,请参阅返回张量中的 `attentions`。
output_hidden_states (`bool`, *可选*) : 是否返回所有层的隐藏状态。有关更多详细信息,请参阅返回张量中的 `hidden_states`。
return_dict (`bool`, *可选*) : 是否返回 [ModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.utils.ModelOutput) 而不是普通元组。
**返回:** [MaskedLMOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) 或 `tuple(torch.Tensor)`
一个 [MaskedLMOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([YosoConfig](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoConfig))和输入。
[YosoForMaskedLM](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoForMaskedLM) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **loss** (`torch.Tensor`,形状为 `(1,)`,*可选*,当提供 `labels` 时返回) -- 掩码语言建模(MLM)损失。
- **logits**(形状为 `(batch_size, sequence_length, config.vocab_size)` 的 `torch.Tensor`)-- 语言建模头的预测分数(SoftMax 之前每个词汇表 token 的分数)。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> from transformers import AutoTokenizer, YosoForMaskedLM
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForMaskedLM.from_pretrained("uw-madison/yoso-4096")
>>> inputs = tokenizer("The capital of France is .", return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # retrieve index of
>>> mask_token_index = (inputs.input_ids == tokenizer.mask_token_id)[0].nonzero(as_tuple=True)[0]
>>> predicted_token_id = logits[0, mask_token_index].argmax(axis=-1)
>>> tokenizer.decode(predicted_token_id)
...
>>> labels = tokenizer("The capital of France is Paris.", return_tensors="pt")["input_ids"]
>>> # mask labels of non- tokens
>>> labels = torch.where(inputs.input_ids == tokenizer.mask_token_id, labels, -100)
>>> outputs = model(**inputs, labels=labels)
>>> round(outputs.loss.item(), 2)
...
```
## YosoForSequenceClassification[[transformers.YosoForSequenceClassification]]
#### transformers.YosoForSequenceClassification[[transformers.YosoForSequenceClassification]]
```python
transformers.YosoForSequenceClassification(config: YosoConfig)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L799)
**参数:**
config ([YosoConfig](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoConfig)):模型配置类,包含模型的所有参数。通过配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
YOSO 模型,顶部带有序列分类/回归头(在池化输出之上添加一个线性层),例如用于 GLUE 任务。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.YosoForSequenceClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L809)
**参数:**
input_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中各个 token 在词汇表中的索引。默认情况下,填充(padding)会被忽略。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取这些索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
token_type_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于指示输入中第一和第二部分的段标记索引。索引取自 `[0, 1]`: - 0 对应 *句子 A* 的标记, - 1 对应 *句子 B* 的标记。 [什么是标记类型 ID?](../glossary#token-type-ids)
position_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中每个 token 在位置嵌入中的位置索引。取值范围为 `[0, config.n_positions - 1]`。[什么是位置 ID?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`,形状为 `(batch_size, sequence_length, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `input_ids`。如果你希望比模型内部的嵌入查找矩阵更精细地控制如何将 `input_ids` 索引转换为对应的向量,这将非常有用。
labels (`torch.LongTensor`,形状为 `(batch_size,)`,*可选*):用于计算序列分类/回归损失的标签。索引应在 `[0, ..., config.num_labels - 1]` 范围内。如果 `config.num_labels == 1`,则计算回归损失(均方损失);如果 `config.num_labels > 1`,则计算分类损失(交叉熵)。
output_attentions (`bool`, *可选*) : 是否返回所有注意力层的注意力张量。有关更多详细信息,请参阅返回张量中的 `attentions`。
output_hidden_states (`bool`, *可选*) : 是否返回所有层的隐藏状态。有关更多详细信息,请参阅返回张量中的 `hidden_states`。
return_dict (`bool`, *可选*) : 是否返回 [ModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.utils.ModelOutput) 而不是普通元组。
**返回:** [SequenceClassifierOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) 或 `tuple(torch.Tensor)`
一个 [SequenceClassifierOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([YosoConfig](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoConfig))和输入。
[YosoForSequenceClassification](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoForSequenceClassification) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **loss** (`torch.Tensor`,形状为 `(1,)`,*可选*,当提供 `labels` 时返回) -- 分类损失(如果 config.num_labels==1,则为回归损失)。
- **logits**(形状为 `(batch_size, config.num_labels)` 的 `torch.Tensor`)-- 分类(或当 config.num_labels==1 时为回归)得分(SoftMax 之前)。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
单标签分类示例:
```python
>>> import torch
>>> from transformers import AutoTokenizer, YosoForSequenceClassification
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForSequenceClassification.from_pretrained("uw-madison/yoso-4096")
>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_class_id = logits.argmax().item()
>>> model.config.id2label[predicted_class_id]
...
>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = YosoForSequenceClassification.from_pretrained("uw-madison/yoso-4096", num_labels=num_labels)
>>> labels = torch.tensor([1])
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
```
多标签分类示例:
```python
>>> import torch
>>> from transformers import AutoTokenizer, YosoForSequenceClassification
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForSequenceClassification.from_pretrained("uw-madison/yoso-4096", problem_type="multi_label_classification")
>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_class_ids = torch.arange(0, logits.shape[-1])[torch.sigmoid(logits).squeeze(dim=0) > 0.5]
>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = YosoForSequenceClassification.from_pretrained(
... "uw-madison/yoso-4096", num_labels=num_labels, problem_type="multi_label_classification"
... )
>>> labels = torch.sum(
... torch.nn.functional.one_hot(predicted_class_ids[None, :].clone(), num_classes=num_labels), dim=1
... ).to(torch.float)
>>> loss = model(**inputs, labels=labels).loss
```
## YosoForMultipleChoice[[transformers.YosoForMultipleChoice]]
#### transformers.YosoForMultipleChoice[[transformers.YosoForMultipleChoice]]
```python
transformers.YosoForMultipleChoice(config: YosoConfig)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L874)
**参数:**
config ([YosoConfig](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoConfig)):模型配置类,包含模型的所有参数。通过配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
带有多个选择分类头的 Yoso 模型(在池化输出之上添加一个线性层和一个 softmax),例如用于 RocStories/SWAG 任务。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.YosoForMultipleChoice.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L885)
**参数:**
input_ids (`torch.LongTensor`,形状为 `(batch_size, num_choices, sequence_length)`):输入序列标记在词汇表中的索引。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor`,形状为 `(batch_size, num_choices, sequence_length)`,*可选*):用于指示输入中第一和第二部分的片段令牌索引。索引选自 `[0, 1]`: - 0 对应 *句子 A* 令牌, - 1 对应 *句子 B* 令牌。 [什么是令牌类型 ID?](../glossary#token-type-ids)
position_ids (`torch.LongTensor`,形状为 `(batch_size, num_choices, sequence_length)`,*可选*):输入序列中每个 token 在位置嵌入中的位置索引。取值范围为 `[0, config.max_position_embeddings - 1]`。[什么是位置 ID?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`,形状为 `(batch_size, num_choices, sequence_length, hidden_size)`,*可选*):可选地,您可以选择直接传入嵌入表示,而不是传入 `input_ids`。如果您希望对 *input_ids* 索引如何转换为相关向量拥有比模型内部嵌入查找矩阵更多的控制权,这将非常有用。
labels (`torch.LongTensor`,形状为 `(batch_size,)`,*可选*):用于计算多项选择分类损失的标签。索引应在 `[0, ..., num_choices-1]` 范围内,其中 `num_choices` 是输入张量第二维的大小。(参见上文中的 `input_ids`)
output_attentions (`bool`, *可选*) : 是否返回所有注意力层的注意力张量。有关更多详细信息,请参阅返回张量中的 `attentions`。
output_hidden_states (`bool`, *可选*) : 是否返回所有层的隐藏状态。有关更多详细信息,请参阅返回张量中的 `hidden_states`。
return_dict (`bool`, *可选*) : 是否返回 [ModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.utils.ModelOutput) 而不是普通元组。
**返回:** [MultipleChoiceModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.MultipleChoiceModelOutput) 或 `tuple(torch.Tensor)`
一个 [MultipleChoiceModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.MultipleChoiceModelOutput) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([YosoConfig](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoConfig))和输入。
[YosoForMultipleChoice](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoForMultipleChoice) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **loss**(形状为 *(1,)* 的 `torch.Tensor`,*可选*,在提供 `labels` 时返回)-- 分类损失。
- **logits**(形状为 `(batch_size, num_choices)` 的 `torch.Tensor`)-- *num_choices* 是输入张量的第二维(参见上方的 *input_ids*)。
分类分数(SoftMax 之前)。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> from transformers import AutoTokenizer, YosoForMultipleChoice
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForMultipleChoice.from_pretrained("uw-madison/yoso-4096")
>>> prompt = "In Italy, pizza served in formal settings, such as at a restaurant, is presented unsliced."
>>> choice0 = "It is eaten with a fork and a knife."
>>> choice1 = "It is eaten while held in the hand."
>>> labels = torch.tensor(0).unsqueeze(0) # choice0 is correct (according to Wikipedia ;)), batch size 1
>>> encoding = tokenizer([prompt, prompt], [choice0, choice1], return_tensors="pt", padding=True)
>>> outputs = model(**{k: v.unsqueeze(0) for k, v in encoding.items()}, labels=labels) # batch size is 1
>>> # the linear classifier still needs to be trained
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## YosoForTokenClassification[[transformers.YosoForTokenClassification]]
#### transformers.YosoForTokenClassification[[transformers.YosoForTokenClassification]]
```python
transformers.YosoForTokenClassification(config: YosoConfig)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L975)
**参数:**
config ([YosoConfig](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoConfig)):模型配置类,包含模型的所有参数。通过配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
带有令牌分类头(即在隐藏状态输出之上添加一个线性层)的 Yoso 转换器,例如用于命名实体识别(NER)任务。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.YosoForTokenClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L987)
**参数:**
input_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中各个 token 在词汇表中的索引。默认情况下,填充(padding)会被忽略。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取这些索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
token_type_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于指示输入中第一和第二部分的段标记索引。索引取自 `[0, 1]`: - 0 对应 *句子 A* 的标记, - 1 对应 *句子 B* 的标记。 [什么是标记类型 ID?](../glossary#token-type-ids)
position_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中每个 token 在位置嵌入中的位置索引。取值范围为 `[0, config.n_positions - 1]`。[什么是位置 ID?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`,形状为 `(batch_size, sequence_length, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `input_ids`。如果你希望比模型内部的嵌入查找矩阵更精细地控制如何将 `input_ids` 索引转换为对应的向量,这将非常有用。
labels (`torch.LongTensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于计算 token 分类损失的标签。索引应在 `[0, ..., config.num_labels - 1]` 范围内。
output_attentions (`bool`, *可选*) : 是否返回所有注意力层的注意力张量。有关更多详细信息,请参阅返回张量中的 `attentions`。
output_hidden_states (`bool`, *可选*) : 是否返回所有层的隐藏状态。有关更多详细信息,请参阅返回张量中的 `hidden_states`。
return_dict (`bool`, *可选*) : 是否返回 [ModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.utils.ModelOutput) 而不是普通元组。
**返回:** [TokenClassifierOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) 或 `tuple(torch.Tensor)`
一个 [TokenClassifierOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([YosoConfig](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoConfig))和输入。
[YosoForTokenClassification](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoForTokenClassification) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **loss** (`torch.Tensor`,形状为 `(1,)`,*可选*,在提供 `labels` 时返回) -- 分类损失。
- **logits**(形状为 `(batch_size, sequence_length, config.num_labels)` 的 `torch.Tensor`)-- 分类分数(SoftMax 之前)。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> from transformers import AutoTokenizer, YosoForTokenClassification
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForTokenClassification.from_pretrained("uw-madison/yoso-4096")
>>> inputs = tokenizer(
... "HuggingFace is a company based in Paris and New York", add_special_tokens=False, return_tensors="pt"
... )
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_token_class_ids = logits.argmax(-1)
>>> # Note that tokens are classified rather then input words which means that
>>> # there might be more predicted token classes than words.
>>> # Multiple token classes might account for the same word
>>> predicted_tokens_classes = [model.config.id2label[t.item()] for t in predicted_token_class_ids[0]]
>>> predicted_tokens_classes
...
>>> labels = predicted_token_class_ids
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
```
## YosoForQuestionAnswering[[transformers.YosoForQuestionAnswering]]
#### transformers.YosoForQuestionAnswering[[transformers.YosoForQuestionAnswering]]
```python
transformers.YosoForQuestionAnswering(config: YosoConfig)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L1046)
**参数:**
config ([YosoConfig](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoConfig)):模型配置类,包含模型的所有参数。通过配置文件进行初始化时,不会加载与模型关联的权重,仅加载配置。请查看 [from_pretrained()](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel.from_pretrained) 方法以加载模型权重。
带有用于抽取式问答任务(如 SQuAD)的跨度分类头的 Yoso transformer(在隐藏状态输出之上添加一个线性层,用于计算`span start logits`和`span end logits`)。
该模型继承自 [PreTrainedModel](/docs/transformers/v5.23.0/zh/main_classes/model#transformers.PreTrainedModel)。请查阅父类文档,了解该库为所有模型实现的通用方法(例如下载或保存、调整输入嵌入大小、剪枝头等)。
该模型也是 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) 的子类。请将其作为常规的 PyTorch Module 使用,有关通用用法和行为的所有事项,请参阅 PyTorch 文档。
#### forward[[transformers.YosoForQuestionAnswering.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, start_positions: typing.Optional[torch.Tensor] = None, end_positions: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[来源](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L1059)
**参数:**
input_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中各个 token 在词汇表中的索引。默认情况下,填充(padding)会被忽略。可以使用 [AutoTokenizer](/docs/transformers/v5.23.0/zh/model_doc/auto#transformers.AutoTokenizer) 获取这些索引。有关详细信息,请参阅 [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) 和 [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/zh/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__)。[什么是输入 ID?](../glossary#input-ids)
attention_mask (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于避免对填充(padding)标记索引执行注意力机制的掩码。掩码值取自 `[0, 1]`: - 1 表示**未掩码**的标记, - 0 表示**已掩码**的标记。 [什么是注意力掩码?](../glossary#attention-mask)
token_type_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):用于指示输入中第一和第二部分的段标记索引。索引取自 `[0, 1]`: - 0 对应 *句子 A* 的标记, - 1 对应 *句子 B* 的标记。 [什么是标记类型 ID?](../glossary#token-type-ids)
position_ids (`torch.Tensor`,形状为 `(batch_size, sequence_length)`,*可选*):输入序列中每个 token 在位置嵌入中的位置索引。取值范围为 `[0, config.n_positions - 1]`。[什么是位置 ID?](../glossary#position-ids)
inputs_embeds (`torch.Tensor`,形状为 `(batch_size, sequence_length, hidden_size)`,*可选*):可选地,你可以选择直接传入嵌入表示,而不是传入 `input_ids`。如果你希望比模型内部的嵌入查找矩阵更精细地控制如何将 `input_ids` 索引转换为对应的向量,这将非常有用。
start_positions (`torch.Tensor`,形状为 `(batch_size,)`,*可选*):用于计算 token 分类损失的标注跨度起始位置(索引)的标签。位置会被截断至序列长度(`sequence_length`)。序列之外的位置在计算损失时不予考虑。
end_positions (`torch.Tensor`,形状为 `(batch_size,)`,*可选*):用于计算 token 分类损失的标注跨度结束位置(索引)的标签。位置会被截断至序列长度(`sequence_length`)。序列之外的位置在计算损失时不予考虑。
output_attentions (`bool`, *可选*) : 是否返回所有注意力层的注意力张量。有关更多详细信息,请参阅返回张量中的 `attentions`。
output_hidden_states (`bool`, *可选*) : 是否返回所有层的隐藏状态。有关更多详细信息,请参阅返回张量中的 `hidden_states`。
return_dict (`bool`, *可选*) : 是否返回 [ModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.utils.ModelOutput) 而不是普通元组。
**返回:** [QuestionAnsweringModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) 或 `tuple(torch.Tensor)`
一个 [QuestionAnsweringModelOutput](/docs/transformers/v5.23.0/zh/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) 或 `torch.Tensor` 元组(如果传入了 `return_dict=False` 或 `config.return_dict=False`),其包含的元素取决于配置([YosoConfig](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoConfig))和输入。
[YosoForQuestionAnswering](/docs/transformers/v5.23.0/zh/model_doc/yoso#transformers.YosoForQuestionAnswering) 的 forward 方法重写了 `__call__` 特殊方法。
尽管前向传播的实现需要在此函数中定义,但之后应调用 `Module` 实例,而不是直接调用此函数,因为前者会负责执行预处理和后处理步骤,而后者会静默地忽略这些步骤。
- **loss** (`torch.Tensor`,形状为 `(1,)`,*可选*,当提供 `labels` 时返回) -- 总跨度提取损失是起始位置和结束位置的交叉熵之和。
- **start_logits**(形状为 `(batch_size, sequence_length)` 的 `torch.Tensor`)-- 跨度起始分数(SoftMax 之前)。
- **end_logits**(形状为 `(batch_size, sequence_length)` 的 `torch.Tensor`)-- 跨度结束分数(SoftMax 之前)。
- **hidden_states** (`tuple(torch.Tensor)`,*可选*,在传入 `output_hidden_states=True` 或 `config.output_hidden_states=True` 时返回) -- 一个 `torch.Tensor` 元组(如果模型具有嵌入层,则包含嵌入层的输出,以及每一层的输出),形状为 `(batch_size, sequence_length, hidden_size)`。
模型在每一层输出处的隐藏状态,以及可选的初始嵌入输出。
- **attentions** (`tuple(torch.Tensor)`,*可选*,当传入 `output_attentions=True` 或 `config.output_attentions=True` 时返回) -- 一个 `torch.Tensor` 元组(每层一个),形状为 `(batch_size, num_heads, sequence_length, sequence_length)`。
经过注意力 softmax 后的注意力权重,用于在自注意力头中计算加权平均值。
示例:
```python
>>> from transformers import AutoTokenizer, YosoForQuestionAnswering
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForQuestionAnswering.from_pretrained("uw-madison/yoso-4096")
>>> question, text = "Who was Jim Henson?", "Jim Henson was a nice puppet"
>>> inputs = tokenizer(question, text, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> answer_start_index = outputs.start_logits.argmax()
>>> answer_end_index = outputs.end_logits.argmax()
>>> predict_answer_tokens = inputs.input_ids[0, answer_start_index : answer_end_index + 1]
>>> tokenizer.decode(predict_answer_tokens, skip_special_tokens=True)
...
>>> # target is "nice puppet"
>>> target_start_index = torch.tensor([14])
>>> target_end_index = torch.tensor([15])
>>> outputs = model(**inputs, start_positions=target_start_index, end_positions=target_end_index)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
...
```