# ViLT
## نظرة عامة
قُدِّم نموذج ViLT في [ViLT: Vision-and-Language Transformer Without Convolution or Region Supervision](https://huggingface.co/papers/2102.03334) من قِبل Wonjae Kim وBokyung Son وIldoo Kim. يدمج ViLT تمثيلات النص في Vision Transformer (ViT)، مما يتيح له تصميمًا بسيطًا للتدريب المسبق على الرؤية واللغة (VLP).
المستخلص من الورقة البحثية هو كالتالي:
*حسّن التدريب المسبق المشترك للرؤية واللغة (VLP) الأداء في مهام الرؤية واللغة المشتركة المختلفة. وتعتمد الأساليب الحالية في VLP بشكل كبير على عمليات استخراج ميزات الصور، ومعظمها يتضمن إشرافًا على المناطق (مثل كشف الكائنات) والبنية التلافيفية (مثل ResNet). وعلى الرغم من إهمال هذه النقطة في الأدبيات، نجد أنها مشكلة من حيث (1) الكفاءة/السرعة، إذ إن استخراج ميزات المدخلات وحده يتطلب حسابات أكثر بكثير من خطوات التفاعل متعدد الوسائط؛ و(2) القدرة التعبيرية، إذ إنها محدودة من الأعلى بقدرة المضمّن البصري التعبيرية ومفرداته البصرية المحددة مسبقًا. في هذه الورقة، نقدم نموذج VLP بسيطًا، وهو Vision-and-Language Transformer (ViLT)، أحادي البنية بمعنى أن معالجة المدخلات البصرية مبسطة بشكل جذري لتتم بنفس الطريقة الخالية من التلافيف التي نعالج بها المدخلات النصية. نوضح أن ViLT أسرع بمقدار يصل إلى عشرات المرات من نماذج VLP السابقة، مع أداء تنافسي أو أفضل في مهام المهام الفرعية.*
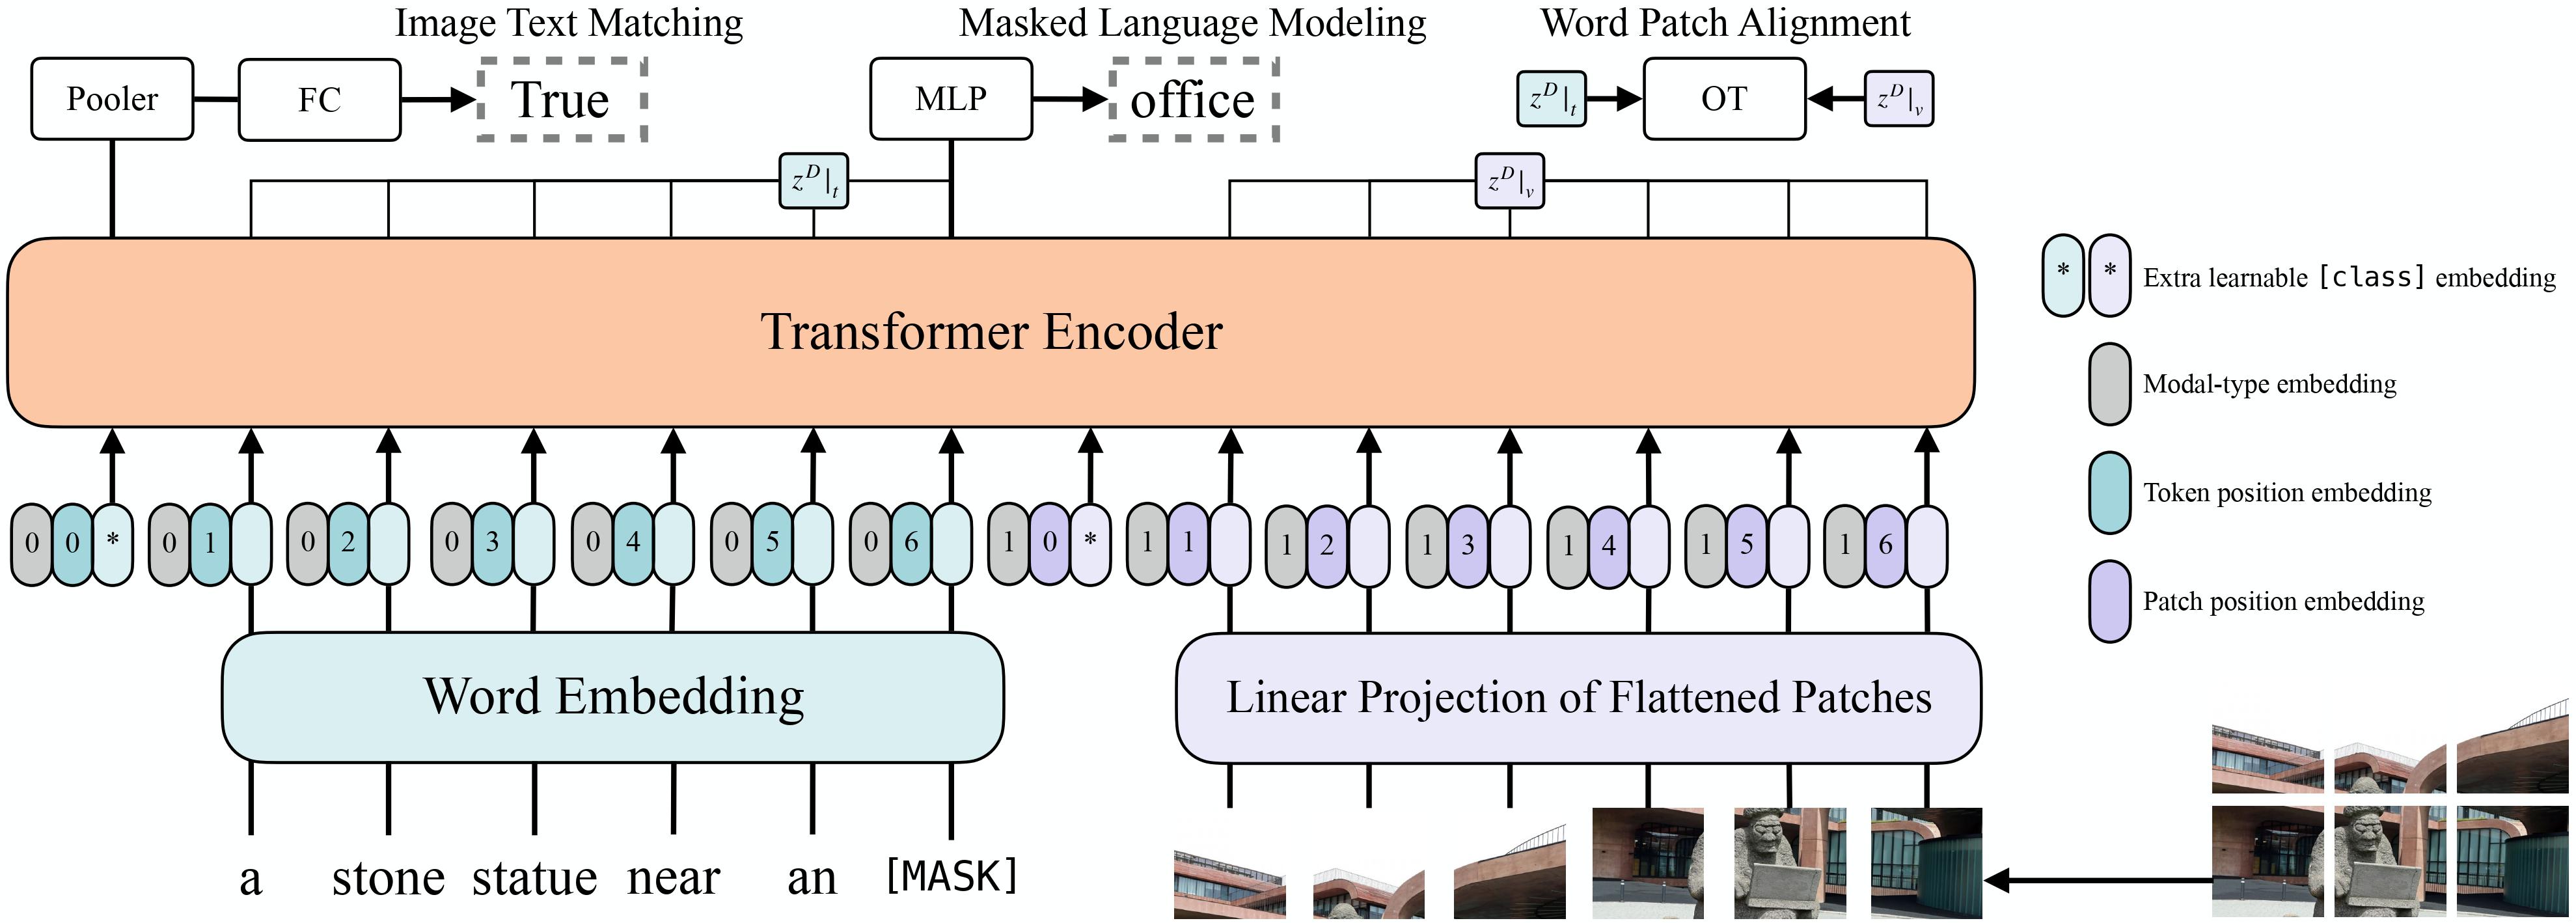 بنية ViLT. مأخوذة من الورقة الأصلية.
تمت مساهمة هذا النموذج من قِبل [nielsr](https://huggingface.co/nielsr). يمكن العثور على الكود الأصلي [هنا](https://github.com/dandelin/ViLT).
## نصائح للاستخدام
- أسرع طريقة للبدء مع ViLT هي الاطلاع على [دفاتر الأمثلة](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/ViLT) (التي تُظهر كلًا من الاستدلال والتدريب الدقيق على بيانات مخصصة).
- ViLT هو نموذج يستقبل كلًا من `pixel_values` و`input_ids` كمدخلات. يمكن استخدام [ViltProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltProcessor) لتحضير البيانات للنموذج. يجمع هذا المعالج بين معالج صور (لنمط الصورة) ومجزئ (لنمط اللغة) في وحدة واحدة.
- يُدرَّب ViLT على صور بأحجام مختلفة: يقوم المؤلفون بتغيير حجم الحافة الأقصر للصور المدخلة إلى 384 وتحديد الحافة الأطول بأقل من 640 مع الحفاظ على نسبة الأبعاد. لجعل تجميع الصور في دفعات ممكنًا، يستخدم المؤلفون `pixel_mask` الذي يحدد أي قيم البكسل حقيقية وأيها حشو. يقوم [ViltProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltProcessor) بإنشائه تلقائيًا نيابةً عنك.
- يُشبه تصميم ViLT إلى حدٍّ كبير تصميم Vision Transformer (ViT) القياسي. والفرق الوحيد هو أن النموذج يتضمن طبقات تضمين إضافية لنمط اللغة.
## ViltConfig[[transformers.ViltConfig]]
#### transformers.ViltConfig[[transformers.ViltConfig]]
```python
transformers.ViltConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 30522, type_vocab_size: int = 2, modality_type_vocab_size: int = 2, max_position_embeddings: int = 40, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 384, patch_size: int | list[int] | tuple[int, int] = 32, num_channels: int = 3, qkv_bias: bool = True, max_image_length: int = -1, tie_word_embeddings: bool = True, num_images: int = -1, pad_token_id: int | None = None)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/configuration_vilt.py#L24)
**المعاملات:**
vocab_size (`int`، *اختياري*، القيمة الافتراضية `30522`) : حجم مفردات النموذج. يحدد عدد الرموز المختلفة التي يمكن تمثيلها بواسطة `input_ids`.
type_vocab_size (`int`، *اختياري*، القيمة الافتراضية `2`) : حجم مفردات `token_type_ids`.
modality_type_vocab_size (`int`، *اختياري*، القيمة الافتراضية 2) : حجم مفردات الأنماط المُمرَّرة عند استدعاء [ViltModel](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltModel). يُستخدم هذا بعد دمج تمثيلات نمطي النص والصورة.
max_position_embeddings (`int`، *اختياري*، القيمة الافتراضية `40`) : الحد الأقصى لطول التسلسل الذي قد يُستخدم به هذا النموذج على الإطلاق.
hidden_size (`int`، *اختياري*، القيمة الافتراضية `768`) : بُعد التمثيلات المخفية.
num_hidden_layers (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد الطبقات المخفية في مُفكِّك Transformer.
num_attention_heads (`int`، *اختياري*، القيمة الافتراضية `12`) : عدد رؤوس الانتباه في كل طبقة انتباه داخل مُفكِّك Transformer.
intermediate_size (`int`، *اختياري*، القيمة الافتراضية `3072`) : بُعد تمثيلات MLP.
hidden_act (`str`، *اختياري*، القيمة الافتراضية `gelu`) : دالة التنشيط غير الخطية (دالة أو نص) في المُفكِّك. على سبيل المثال، `"gelu"`، `"relu"`، `"silu"`، وما إلى ذلك.
hidden_dropout_prob (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.0`) : احتمال الإسقاط (dropout) لجميع الطبقات المتصلة بالكامل في التضمينات (embeddings) والمشفّر (encoder) والمجمّع (pooler).
attention_probs_dropout_prob (`Union[float, int]`، *اختياري*، القيمة الافتراضية `0.0`) : نسبة الإسقاط (dropout) لاحتمالات الانتباه.
initializer_range (`float`، *اختياري*، القيمة الافتراضية `0.02`) : الانحراف المعياري لـ truncated_normal_initializer المستخدم في تهيئة جميع مصفوفات الأوزان.
layer_norm_eps (`float`، *اختياري*، القيمة الافتراضية `1e-12`) : قيمة الإيبسلون المستخدمة في طبقات تطبيع الطبقة.
image_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية هي `384`) : حجم (دقة) كل صورة.
patch_size (`Union[int, list[int], tuple[int, int]]`، *اختياري*، القيمة الافتراضية `32`) : حجم (دقة) كل رقعة.
num_channels (`int`، *اختياري*، القيمة الافتراضية `3`) : عدد قنوات الإدخال.
qkv_bias (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إضافة انحياز إلى الاستعلامات والمفاتيح والقيم.
max_image_length (`int`، *اختياري*، القيمة الافتراضية -1) : الحد الأقصى لعدد البقع (patches) التي تُؤخذ كمدخلات لمشفّر Transformer. إذا تم ضبطه على عدد صحيح موجب، فسيعتمد المشفّر على `max_image_length` كحد أقصى لعدد البقع. إذا تم ضبطه على -1، فلن يُؤخذ في الاعتبار.
tie_word_embeddings (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب ربط ترميزات الأوزان وفقاً لخريطة `tied_weights_keys` الخاصة بالنموذج.
num_images (`int`، *اختياري*، القيمة الافتراضية -1) : عدد الصور المستخدمة للاستدلال البصري باللغة الطبيعية. إذا تم ضبطه على عدد صحيح موجب، فسيُستخدم بواسطة [ViltForImagesAndTextClassification](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltForImagesAndTextClassification) لتعريف رأس المصنّف.
pad_token_id (`int`, *اختياري*) : معرّف الرمز (Token id) المستخدم للتعبئة (padding) في المفردات.
هذه فئة الإعدادات المخزنة لإعدادات نموذج ViltModel. تُستخدم لتوليد نموذج Vilt وفقاً للحجج المحددة، مع تعريف بنية النموذج. إن إنشاء إعدادات باستخدام القيم الافتراضية سيؤدي إلى الحصول على إعدادات مشابهة لتلك الخاصة بـ [dandelin/vilt-b32-mlm](https://huggingface.co/dandelin/vilt-b32-mlm)
ترث كائنات الإعداد من [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) ويمكن استخدامها للتحكم في مخرجات النموذج. اقرأ التوثيق الخاص بـ [PreTrainedConfig](/docs/transformers/v5.23.0/ar/main_classes/configuration#transformers.PreTrainedConfig) لمزيد من المعلومات.
مثال:
```python
>>> from transformers import ViLTModel, ViLTConfig
>>> # Initializing a ViLT dandelin/vilt-b32-mlm style configuration
>>> configuration = ViLTConfig()
>>> # Initializing a model from the dandelin/vilt-b32-mlm style configuration
>>> model = ViLTModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ViltImageProcessor[[transformers.ViltImageProcessor]]
#### transformers.ViltImageProcessor[[transformers.ViltImageProcessor]]
```python
transformers.ViltImageProcessor(**kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/image_processing_vilt.py#L52)
**المعاملات:**
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*، الافتراضي هو `True`) : ما إذا كان سيتم تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية `{'shortest_edge' : 384}`): يصف الأبعاد القصوى للإدخال إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*، الافتراضي `False`) : ما إذا كان سيتم افتراض صورة مربعة عند تغيير الحجم، إذا كان size من نوع int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`، *kwargs*، القيمة الافتراضية `3`) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كانت قيمة `do_resize` هي `True`.
do_rescale (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*، القيمة الافتراضية هي `0.00392156862745098`) : عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطاً على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية هي `[0.5, 0.5, 0.5]`) : متوسط الصورة المستخدم للتطبيع. لا يكون له تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية هي `[0.5, 0.5, 0.5]`) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم إضافة حشوة إلى الصورة. تتم الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *optional*) : عدد رموز الصور المستخدمة لكل صورة في المدخلات. أُضيف للتوافق الرجعي، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. يعيد تينسورات مكدسة إذا ضُبط على `'pt'`، وإلا يعيد قائمة من التينسورات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *optional*) : عدد رموز الصور المستخدمة لكل صورة في المدخلات. أُضيف للتوافق الرجعي، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. يعيد تينسورات مكدسة إذا ضُبط على `'pt'`، وإلا يعيد قائمة من التينسورات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *optional*) : عدد رموز الصور المستخدمة لكل صورة في المدخلات. أُضيف للتوافق الرجعي، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. يعيد تينسورات مكدسة إذا ضُبط على `'pt'`، وإلا يعيد قائمة من التينسورات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *optional*) : عدد رموز الصور المستخدمة لكل صورة في المدخلات. أُضيف للتوافق الرجعي، لكن ينبغي ضبطه كخاصية للمعالج في النماذج المستقبلية. يعيد تينسورات مكدسة إذا ضُبط على `'pt'`، وإلا يعيد قائمة من التينسورات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
يعيد تينسورات مكدسة إذا تم ضبطه على `'pt'`، وإلا يعيد قائمة من التينسورات. --
ينشئ معالج صور ViltImageProcessor.
disable_grouping (`bool`، *kwargs*، *اختياري*): هل يتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي وليس على شكل دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على CPU، وإلا فسيتم تعيينها إلى False. هذا الاختيار مبني على ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 image_seq_length (`int`، *kwargs*، *اختياري*): عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت للتوافق مع الإصدارات السابقة، لكن يجب تعيينها كخاصية لـ processor في النماذج المستقبلية.
#### preprocess[[transformers.ViltImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : الصورة المراد معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`، *اختياري*) : علم مخصص للمطورين لإدخال مدخلات إضافية تشبه الصور والتي سيتم معالجتها مسبقًا أيضًا. استخدم هذا الخيار فقط إذا لم يعمل تمرير المدخلات كحجة اسمية (kwarg). على سبيل المثال، يُعد `preprocess(images, masks=masks)` الخيار المفضل، لكنه يؤدي إلى مشاكل في أولوية الحجة لبعض النماذج. في تلك الحالات، يمكن استخدام `preprocess(images, image_like_inputs={"masks": masks})` بدلاً منه.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم عددًا صحيحًا.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*) : معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطًا على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
معالجة صورة أو دفعة من الصور مسبقًا.
## ViltImageProcessorPil[[transformers.ViltImageProcessorPil]]
#### transformers.ViltImageProcessorPil[[transformers.ViltImageProcessorPil]]
```python
transformers.ViltImageProcessorPil(**kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/image_processing_pil_vilt.py#L113)
**المعاملات:**
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*، الافتراضي هو `True`) : ما إذا كان سيتم تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*، القيمة الافتراضية `{'shortest_edge' : 384}`): يصف الأبعاد القصوى للإدخال إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*، الافتراضي `False`) : ما إذا كان سيتم افتراض صورة مربعة عند تغيير الحجم، إذا كان size من نوع int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`، *kwargs*، القيمة الافتراضية `3`) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كانت قيمة `do_resize` هي `True`.
do_rescale (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*، القيمة الافتراضية هي `0.00392156862745098`) : عامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطاً على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية هي `[0.5, 0.5, 0.5]`) : متوسط الصورة المستخدم للتطبيع. لا يكون له تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*، القيمة الافتراضية هي `[0.5, 0.5, 0.5]`) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان سيتم إضافة حشوة إلى الصورة. تتم الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
يعيد تينسورات مكدسة إذا تم ضبطه على `'pt'`، وإلا يعيد قائمة من التينسورات. --
ينشئ معالج صور ViltImageProcessor.
disable_grouping (`bool`، *kwargs*، *اختياري*): هل يتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي وليس على شكل دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على CPU، وإلا فسيتم تعيينها إلى False. هذا الاختيار مبني على ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157 image_seq_length (`int`، *kwargs*، *اختياري*): عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت للتوافق مع الإصدارات السابقة، لكن يجب تعيينها كخاصية لـ processor في النماذج المستقبلية.
#### preprocess[[transformers.ViltImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : الصورة المراد معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`، *اختياري*) : علم مخصص للمطورين لإدخال مدخلات إضافية تشبه الصور والتي سيتم معالجتها مسبقًا أيضًا. استخدم هذا الخيار فقط إذا لم يعمل تمرير المدخلات كحجة اسمية (kwarg). على سبيل المثال، يُعد `preprocess(images, masks=masks)` الخيار المفضل، لكنه يؤدي إلى مشاكل في أولوية الحجة لبعض النماذج. في تلك الحالات، يمكن استخدام `preprocess(images, image_like_inputs={"masks": masks})` بدلاً منه.
do_convert_rgb (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تحويل الصورة إلى RGB.
do_resize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تغيير حجم الصورة.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : يصف الأبعاد القصوى للمدخلات إلى النموذج.
default_to_square (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب افتراض صورة مربعة عند تغيير الحجم، إذا كان الحجم عددًا صحيحًا.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`، *kwargs*) : حجم الصورة الناتجة بعد تطبيق `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : مرشح إعادة العينة المستخدم عند تغيير حجم الصورة. يمكن أن يكون أحد قيم enum `PILImageResampling`. لا يؤثر إلا إذا كان `do_resize` مضبوطاً على `True`.
do_rescale (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إعادة تحجيم الصورة.
rescale_factor (`float`، *kwargs*، *اختياري*) : معامل إعادة التحجيم لإعادة تحجيم الصورة إذا كان `do_rescale` مضبوطًا على `True`.
do_normalize (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب تطبيع الصورة.
image_mean (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : متوسط الصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`، *kwargs*، *اختياري*) : الانحراف المعياري للصورة المستخدم للتطبيع. لا يكون له أي تأثير إلا إذا تم تعيين `do_normalize` إلى `True`.
do_pad (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب إضافة حشوة إلى الصورة. يتم تنفيذ الحشوة إما إلى أكبر حجم في الدفعة أو إلى حجم مربع ثابت لكل صورة. تعتمد استراتيجية الحشوة الدقيقة على النموذج.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : الحجم على شكل `{"height": int, "width" int}` الذي يجب توسيد الصور إليه. يجب أن يكون أكبر من أي حجم صورة مُقدَّم للمعالجة المسبقة. إذا لم يُقدَّم `pad_size`، فسيتم توسيد الصور إلى أكبر ارتفاع وعرض في الدفعة. يُطبَّق فقط عندما يكون `do_pad=True.`
do_center_crop (`bool`، *kwargs*، *اختياري*) : ما إذا كان يجب قص الصورة من المنتصف.
data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : يُدعم `ChannelDimension.FIRST` فقط. أُضيف من أجل التوافق مع المعالجات البطيئة.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`، *kwargs*، *اختياري*) : تنسيق بُعد القناة للصورة المدخلة. إذا لم يتم ضبطه، يُستنتج تنسيق بُعد القناة من الصورة المدخلة. يمكن أن يكون أحد ما يلي: - `"channels_first"` أو `ChannelDimension.FIRST`: صورة بتنسيق (num_channels, height, width). - `"channels_last"` أو `ChannelDimension.LAST`: صورة بتنسيق (height, width, num_channels). - `"none"` أو `ChannelDimension.NONE`: صورة بتنسيق (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : الجهاز الذي تتم عليه معالجة مقاطع الفيديو. إذا لم يتم ضبطه، يُستنتج الجهاز من مقاطع الفيديو المدخلة.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : تُرجع توتنرات مكدّسة إذا كان الإعداد `'pt'`، وإلا تُرجع قائمة من التوتنرات.
disable_grouping (`bool`، *kwargs*، *اختياري*) : ما إذا كان سيتم تعطيل تجميع الصور حسب الحجم لمعالجتها بشكل فردي بدلاً من دفعات. إذا كانت القيمة None، فسيتم تعيينها إلى True إذا كانت الصور على وحدة المعالجة المركزية (CPU)، وإلا فستكون False. تستند هذه الخيارات إلى ملاحظات تجريبية، كما هو موضح هنا: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`، *kwargs*، *اختياري*) : عدد رموز الصور التي سيتم استخدامها لكل صورة في المدخلات. أُضيفت لضمان التوافق مع الإصدارات السابقة، لكن ينبغي ضبطها كخاصية للمعالج في النماذج المستقبلية.
**يعيد:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- قاموس من القوائم/المصفوفات/الموترات التي يعيدها أسلوب __call__ ('pixel_values'، وما إلى ذلك).
- **tensor_type** (`Union[None, str, TensorType]`، *اختياري*) -- يمكنك تحديد tensor_type هنا لتحويل قوائم الأعداد الصحيحة إلى تينسورات PyTorch/Numpy عند التهيئة.
معالجة صورة أو دفعة من الصور مسبقًا.
## ViltProcessor[[transformers.ViltProcessor]]
#### transformers.ViltProcessor[[transformers.ViltProcessor]]
```python
transformers.ViltProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/processing_vilt.py#L24)
**المعاملات:**
image_processor (`ViltImageProcessor`) : مُعالِج الصور هو مدخل إلزامي.
tokenizer (`BertTokenizer`) : مُجزِّئ النص (tokenizer) هو مدخل إلزامي.
ينشئ معالج ViltProcessor يجمع معالج الصور ومجزئ الرموز في معالج واحد.
يوفر [ViltProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltProcessor) جميع وظائف [ViltImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltImageProcessor) و[BertTokenizer](/docs/transformers/v5.23.0/ar/model_doc/lxmert#transformers.BertTokenizer). راجع [~ViltImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltImageProcessor) و[~BertTokenizer](/docs/transformers/v5.23.0/ar/model_doc/lxmert#transformers.BertTokenizer) لمزيد من المعلومات.
#### __call__[[transformers.ViltProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L670)
**المعاملات:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *اختياري*) : الصورة التي سيتم معالجتها مسبقًا. يتوقع صورة واحدة أو دفعة من الصور بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر صورًا بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`، *اختياري*) : التسلسل أو الدفعة من التسلسلات المراد ترميزها. يمكن أن يكون كل تسلسل نصًا أو قائمة من النصوص (نص مُجزَّأ مسبقًا). إذا مررت مدخلات مُجزَّأة مسبقًا، فاضبط `is_split_into_words=True` لتجنب الغموض مع المدخلات المُجمَّعة في دفعات.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`، *اختياري*) : الفيديو المراد معالجته مسبقًا. يتوقع إدخال فيديو واحد أو دفعة من الفيديوهات بقيم بكسل تتراوح بين 0 و255. إذا كنت تمرر فيديوهات بقيم بكسل بين 0 و1، فاضبط `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`، *اختياري*) : الصوت أو مجموعة الأصوات التي يجب تجهيزها. يمكن أن يكون كل صوت مصفوفة NumPy أو متجه PyTorch. في حالة استخدام مصفوفة NumPy/متجه PyTorch، يجب أن يكون شكل كل صوت (C, T)، حيث C هو عدد القنوات، وT هو طول العينة للصوت.
return_mm_token_type_ids (`bool`, *kwargs*) : ما إذا كان يجب إرجاع معرّفات أنواع الرموز متعددة الوسائط التي تشير إلى مواضع رموز الحشو متعددة الوسائط.
return_text_replacement_offsets (`bool`، *kwargs*) : ما إذا كان يجب إرجاع إزاحات الأحرف لكل عنصر نائب متعدد الوسائط (multimodal placeholder) وعنصر الاستبدال الخاص به.
return_tensors (`str` أو [TensorType](/docs/transformers/v5.23.0/ar/internal/file_utils#transformers.TensorType)، *اختياري*) : إذا تم تعيينه، فسيُرجع تينسورات من إطار عمل محدد. القيم المقبولة هي: - `'pt'`: يُرجع كائنات `torch.Tensor` من PyTorch. - `'np'`: يُرجع كائنات `np.ndarray` من NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/ar/main_classes/processors#transformers.ProcessingKwargs)، *اختياري*) : خيارات معالجة إضافية لكل نمط (نص، صور، مقاطع فيديو، صوت). تُدرج المعلمات الخاصة بالنموذج أعلاه؛ راجع فئة TypedDict للحصول على القائمة الكاملة للحجج المدعومة.
## ViltModel[[transformers.ViltModel]]
#### transformers.ViltModel[[transformers.ViltModel]]
```python
transformers.ViltModel(config: ViltConfig, add_pooling_layer = True)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L511)
**المعاملات:**
config ([ViltConfig](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
add_pooling_layer (`bool`، *اختياري*، القيمة الافتراضية `True`) : ما إذا كان يجب إضافة طبقة تجميع
نموذج Vilt الأساسي الذي يُخرج حالات مخفية خام دون أي رأس محدد في الأعلى.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.ViltModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, image_token_type_idx: int | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L535)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار الفهارس من `[0, 1]`: - 0 يقابل رمز *الجملة أ*، - 1 يقابل رمز *الجملة ب*. [ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام [ViltImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltImageProcessor). راجع [ViltImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([ViltProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltProcessor) يستخدم [ViltImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltImageProcessor) لمعالجة الصور).
pixel_mask (`torch.LongTensor` من الشكل `(batch_size, height, width)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على قيم البكسلات المعبأة. قيم القناع المختارة في `[0, 1]`: - 1 للبكسلات الحقيقية (أي **غير المقنّعة**)، - 0 للبكسلات المعبأة (أي **المقنّعة**). [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
image_embeds (`torch.Tensor` بأبعاد `(batch_size, num_patches, hidden_size)`، *اختياري*) : اختياريًا، بدلاً من تمرير `pixel_values`، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. يكون هذا مفيدًا إذا أردت مزيدًا من التحكم في كيفية تحويل `pixel_values` إلى تضمينات البقع.
image_token_type_idx (`int`, *اختياري*) : - معرّفات أنواع الرموز للصور.
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) أو مجموعة مرتبة من `torch.Tensor` (في حال تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([ViltConfig](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltConfig)) والمدخلات.
تتجاوز طريقة [ViltModel](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltModel) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **last_hidden_state** (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`) -- تسلسل من حالات الإخفاء (hidden-states) عند مخرج الطبقة الأخيرة من النموذج.
- **pooler_output** (`torch.Tensor` من الشكل `(batch_size, hidden_size)`) -- حالة الطبقة المخفية الأخيرة للرمز الأول في التسلسل (رمز التصنيف) بعد المعالجة الإضافية عبر الطبقات المستخدمة في مهمة ما قبل التدريب المساعدة. على سبيل المثال، بالنسبة لعائلة نماذج BERT، تُرجع هذه الخاصية رمز التصنيف بعد معالجته عبر طبقة خطية ودالة تفعيل tanh. يتم تدريب أوزان الطبقة الخطية من هدف التنبؤ بالجملة التالية (التصنيف) أثناء ما قبل التدريب.
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import ViltProcessor, ViltModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> # prepare image and text
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "hello world"
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-mlm")
>>> model = ViltModel.from_pretrained("dandelin/vilt-b32-mlm")
>>> inputs = processor(image, text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ViltForMaskedLM[[transformers.ViltForMaskedLM]]
#### transformers.ViltForMaskedLM[[transformers.ViltForMaskedLM]]
```python
transformers.ViltForMaskedLM(config: ViltConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L671)
**المعاملات:**
config ([ViltConfig](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج ViLT مع رأس لنمذجة اللغة في الأعلى كما تم خلال التدريب المسبق.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.ViltForMaskedLM.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L692)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار الفهارس من `[0, 1]`: - 0 يقابل رمز *الجملة أ*، - 1 يقابل رمز *الجملة ب*. [ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام [ViltImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltImageProcessor). راجع [ViltImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([ViltProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltProcessor) يستخدم [ViltImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltImageProcessor) لمعالجة الصور).
pixel_mask (`torch.LongTensor` من الشكل `(batch_size, height, width)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على قيم البكسلات المعبأة. قيم القناع المختارة في `[0, 1]`: - 1 للبكسلات الحقيقية (أي **غير المقنّعة**)، - 0 للبكسلات المعبأة (أي **المقنّعة**). [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
image_embeds (`torch.Tensor` بأبعاد `(batch_size, num_patches, hidden_size)`، *اختياري*) : اختياريًا، بدلاً من تمرير `pixel_values`، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. يكون هذا مفيدًا إذا أردت مزيدًا من التحكم في كيفية تحويل `pixel_values` إلى تضمينات البقع.
labels (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : التسميات لحساب خسارة نمذجة اللغة المقنّعة. يجب أن تكون الفهارس ضمن `[-100, 0, ..., config.vocab_size]` (انظر `input_ids` docstring). يتم تجاهل الرموز التي تكون فهارسها مضبوطة على `-100` (مقنّعة)، ولا تُحسب الخسارة إلا للرموز التي تسمياتها ضمن `[0, ..., config.vocab_size]`.
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** [MaskedLMOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) أو `tuple(torch.Tensor)`
[MaskedLMOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) أو مجموعة مرتبة من `torch.Tensor` (في حال تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) تتكون من عناصر مختلفة اعتماداً على الإعداد ([ViltConfig](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltConfig)) والمدخلات.
تُعيد طريقة [ViltForMaskedLM](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltForMaskedLM) الخاصة بالتقديم (forward) تعريف الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`، *اختياري*، يُعاد عند توفير `labels`) -- خسارة نمذجة اللغة المقنّعة (MLM).
- **logits** (`torch.Tensor` من الشكل `(batch_size, sequence_length, config.vocab_size)`) -- درجات التنبؤ لرأس نمذجة اللغة (درجات لكل رمز في المفردات قبل SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import ViltProcessor, ViltForMaskedLM
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import re
>>> import torch
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "a bunch of [MASK] laying on a [MASK]."
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-mlm")
>>> model = ViltForMaskedLM.from_pretrained("dandelin/vilt-b32-mlm")
>>> # prepare inputs
>>> encoding = processor(image, text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**encoding)
>>> tl = len(re.findall("\[MASK\]", text))
>>> inferred_token = [text]
>>> # gradually fill in the MASK tokens, one by one
>>> with torch.no_grad():
... for i in range(tl):
... encoded = processor.tokenizer(inferred_token)
... input_ids = torch.tensor(encoded.input_ids)
... encoded = encoded["input_ids"][0][1:-1]
... outputs = model(input_ids=input_ids, pixel_values=encoding.pixel_values)
... mlm_logits = outputs.logits[0] # shape (seq_len, vocab_size)
... # only take into account text features (minus CLS and SEP token)
... mlm_logits = mlm_logits[1 : input_ids.shape[1] - 1, :]
... mlm_values, mlm_ids = mlm_logits.softmax(dim=-1).max(dim=-1)
... # only take into account text
... mlm_values[torch.tensor(encoded) != 103] = 0
... select = mlm_values.argmax().item()
... encoded[select] = mlm_ids[select].item()
... inferred_token = [processor.decode(encoded)]
>>> selected_token = ""
>>> encoded = processor.tokenizer(inferred_token)
>>> output = processor.decode(encoded.input_ids[0], skip_special_tokens=True)
>>> print(output)
a bunch of cats laying on a couch.
```
## ViltForQuestionAnswering[[transformers.ViltForQuestionAnswering]]
#### transformers.ViltForQuestionAnswering[[transformers.ViltForQuestionAnswering]]
```python
transformers.ViltForQuestionAnswering(config: ViltConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L840)
**المعاملات:**
config ([ViltConfig](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج Vilt مُحوِّل (Transformer) مع رأس مُصنِّف (Classifier) في الأعلى (طبقة خطية فوق الحالة المخفية النهائية لرمز [CLS]) للإجابة على الأسئلة البصرية، مثل VQAv2.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.ViltForQuestionAnswering.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L858)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار الفهارس من `[0, 1]`: - 0 يقابل رمز *الجملة أ*، - 1 يقابل رمز *الجملة ب*. [ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام [ViltImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltImageProcessor). راجع [ViltImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([ViltProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltProcessor) يستخدم [ViltImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltImageProcessor) لمعالجة الصور).
pixel_mask (`torch.LongTensor` من الشكل `(batch_size, height, width)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على قيم البكسلات المعبأة. قيم القناع المختارة في `[0, 1]`: - 1 للبكسلات الحقيقية (أي **غير المقنّعة**)، - 0 للبكسلات المعبأة (أي **المقنّعة**). [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
image_embeds (`torch.Tensor` بأبعاد `(batch_size, num_patches, hidden_size)`، *اختياري*) : اختياريًا، بدلاً من تمرير `pixel_values`، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. يكون هذا مفيدًا إذا أردت مزيدًا من التحكم في كيفية تحويل `pixel_values` إلى تضمينات البقع.
labels (`torch.Tensor` من الشكل `(batch_size, num_labels)`، *اختياري*) : تسميات لحساب خسارة الإجابة البصرية على الأسئلة. يجب أن يكون هذا المصفوف إما ترميزًا أحاديًا (one-hot) لجميع الإجابات المطبقة على مثال معين في الدفعة، أو ترميزًا ناعمًا (soft encoding) يُظهر أي الإجابات مطبقة، حيث تكون 1.0 هي أعلى درجة.
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** [SequenceClassifierOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) أو `tuple(torch.Tensor)`
[SequenceClassifierOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) أو مجموعة مرتبة من `torch.Tensor` (في حال تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([ViltConfig](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltConfig)) والمدخلات.
تُعيد طريقة [ViltForQuestionAnswering](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltForQuestionAnswering) الخاصة بالتقديم (forward) تعريف الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`, *اختياري*، يُعاد عند تقديم `labels`) -- خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).
- **logits** (`torch.Tensor` من الشكل `(batch_size, config.num_labels)`) -- درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import ViltProcessor, ViltForQuestionAnswering
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "How many cats are there?"
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-vqa")
>>> model = ViltForQuestionAnswering.from_pretrained("dandelin/vilt-b32-finetuned-vqa")
>>> # prepare inputs
>>> encoding = processor(image, text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**encoding)
>>> logits = outputs.logits
>>> idx = logits.argmax(-1).item()
>>> print("Predicted answer:", model.config.id2label[idx])
Predicted answer: 2
```
## ViltForImagesAndTextClassification[[transformers.ViltForImagesAndTextClassification]]
#### transformers.ViltForImagesAndTextClassification[[transformers.ViltForImagesAndTextClassification]]
```python
transformers.ViltForImagesAndTextClassification(config: ViltConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L1052)
**المعاملات:**
config ([ViltConfig](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج Vilt محوّل (Transformer) مع رأس تصنيف في الأعلى للاستدلال البصري على اللغة الطبيعية، مثل NLVR2.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.ViltForImagesAndTextClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L1071)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار الفهارس من `[0, 1]`: - 0 يقابل رمز *الجملة أ*، - 1 يقابل رمز *الجملة ب*. [ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام [ViltImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltImageProcessor). راجع [ViltImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([ViltProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltProcessor) يستخدم [ViltImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltImageProcessor) لمعالجة الصور).
pixel_mask (`torch.LongTensor` من الشكل `(batch_size, height, width)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على قيم البكسلات المعبأة. قيم القناع المختارة في `[0, 1]`: - 1 للبكسلات الحقيقية (أي **غير المقنّعة**)، - 0 للبكسلات المعبأة (أي **المقنّعة**). [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
image_embeds (`torch.Tensor` بأبعاد `(batch_size, num_patches, hidden_size)`، *اختياري*) : اختياريًا، بدلاً من تمرير `pixel_values`، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. يكون هذا مفيدًا إذا أردت مزيدًا من التحكم في كيفية تحويل `pixel_values` إلى تضمينات البقع.
labels (`torch.LongTensor` من الشكل `(batch_size,)`، *اختياري*) : تسميات التصنيف الثنائي.
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** `ViltForImagesAndTextClassificationOutput` أو `tuple(torch.Tensor)`
`ViltForImagesAndTextClassificationOutput` أو مجموعة مرتبة من `torch.Tensor` (في حال تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعدادات ([ViltConfig](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltConfig)) والمدخلات.
تتجاوز طريقة [ViltForImagesAndTextClassification](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltForImagesAndTextClassification) الخاصة بالتقديم الأمامي الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`, *اختياري*، يُعاد عند تقديم `labels`) -- خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).
- **logits** (`torch.Tensor` من الشكل `(batch_size, config.num_labels)`) -- درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).
- **hidden_states** (`list[tuple(torch.Tensor)]`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- قائمة من الأ_tuples من `torch.Tensor` (واحد لكل زوج صورة-نص، حيث يحتوي كل tuple على مخرجات التضمينات + واحد لكل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`. حالات المخفية للنموذج عند مخرجات كل طبقة بالإضافة إلى مخرجات التضمين الأولية.
- **attentions** (`list[tuple[torch.Tensor]]`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة مرتبة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import ViltProcessor, ViltForImagesAndTextClassification
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url_1 = "https://lil.nlp.cornell.edu/nlvr/exs/ex0_0.jpg"
>>> with httpx.stream("GET", url_1) as response:
... image_1 = Image.open(BytesIO(response.read()))
>>> url_2 = "https://lil.nlp.cornell.edu/nlvr/exs/ex0_1.jpg"
>>> with httpx.stream("GET", url_2) as response:
... image_2 = Image.open(BytesIO(response.read()))
>>> text = "The left image contains twice the number of dogs as the right image."
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-nlvr2")
>>> model = ViltForImagesAndTextClassification.from_pretrained("dandelin/vilt-b32-finetuned-nlvr2")
>>> # prepare inputs
>>> encoding = processor([image_1, image_2], text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(input_ids=encoding.input_ids, pixel_values=encoding.pixel_values.unsqueeze(0))
>>> logits = outputs.logits
>>> idx = logits.argmax(-1).item()
>>> print("Predicted answer:", model.config.id2label[idx])
Predicted answer: True
```
## ViltForImageAndTextRetrieval[[transformers.ViltForImageAndTextRetrieval]]
#### transformers.ViltForImageAndTextRetrieval[[transformers.ViltForImageAndTextRetrieval]]
```python
transformers.ViltForImageAndTextRetrieval(config: ViltConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L953)
**المعاملات:**
config ([ViltConfig](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج Vilt مُحوِّل (Transformer) مع رأس مُصنِّف (Classifier) في الأعلى (طبقة خطية فوق الحالة المخفية النهائية لرمز [CLS]) لاسترجاع الصور إلى النص أو النص إلى الصور، مثل MSCOCO وF30K.
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.ViltForImageAndTextRetrieval.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L965)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار الفهارس من `[0, 1]`: - 0 يقابل رمز *الجملة أ*، - 1 يقابل رمز *الجملة ب*. [ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام [ViltImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltImageProcessor). راجع [ViltImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([ViltProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltProcessor) يستخدم [ViltImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltImageProcessor) لمعالجة الصور).
pixel_mask (`torch.LongTensor` من الشكل `(batch_size, height, width)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على قيم البكسلات المعبأة. قيم القناع المختارة في `[0, 1]`: - 1 للبكسلات الحقيقية (أي **غير المقنّعة**)، - 0 للبكسلات المعبأة (أي **المقنّعة**). [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
image_embeds (`torch.Tensor` بأبعاد `(batch_size, num_patches, hidden_size)`، *اختياري*) : اختياريًا، بدلاً من تمرير `pixel_values`، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. يكون هذا مفيدًا إذا أردت مزيدًا من التحكم في كيفية تحويل `pixel_values` إلى تضمينات البقع.
labels (`torch.LongTensor` من الشكل `(batch_size,)`، *اختياري*) : التسميات غير مدعومة حاليًا.
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** [SequenceClassifierOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) أو `tuple(torch.Tensor)`
[SequenceClassifierOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) أو مجموعة مرتبة من `torch.Tensor` (في حال تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([ViltConfig](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltConfig)) والمدخلات.
تتجاوز طريقة [ViltForImageAndTextRetrieval](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltForImageAndTextRetrieval) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` من الشكل `(1,)`, *اختياري*، يُعاد عند تقديم `labels`) -- خسارة التصنيف (أو الانحدار إذا كان config.num_labels==1).
- **logits** (`torch.Tensor` من الشكل `(batch_size, config.num_labels)`) -- درجات التصنيف (أو الانحدار إذا كان config.num_labels==1) (قبل SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
أمثلة:
```python
>>> from transformers import ViltProcessor, ViltForImageAndTextRetrieval
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
>>> processor = ViltProcessor.from_pretrained("dandelin/vilt-b32-finetuned-coco")
>>> model = ViltForImageAndTextRetrieval.from_pretrained("dandelin/vilt-b32-finetuned-coco")
>>> # forward pass
>>> scores = dict()
>>> for text in texts:
... # prepare inputs
... encoding = processor(image, text, return_tensors="pt")
... outputs = model(**encoding)
... scores[text] = outputs.logits[0, :].item()
```
## ViltForTokenClassification[[transformers.ViltForTokenClassification]]
#### transformers.ViltForTokenClassification[[transformers.ViltForTokenClassification]]
```python
transformers.ViltForTokenClassification(config: ViltConfig)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L1194)
**المعاملات:**
config ([ViltConfig](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltConfig)) : فئة إعدادات النموذج التي تحتوي على جميع معاملات النموذج. عند التهيئة باستخدام ملف إعدادات، لا يتم تحميل الأوزان المرتبطة بالنموذج، بل الإعدادات فقط. راجع طريقة [from_pretrained()](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel.from_pretrained) لتحميل أوزان النموذج.
نموذج Vilt transformer مع رأس تصنيف الرموز في الأعلى (طبقة خطية فوق مخرجات الحالات المخفية)، على سبيل المثال لمهام التعرف على الكيانات المسمّاة (NER).
يرث هذا النموذج من [PreTrainedModel](/docs/transformers/v5.23.0/ar/main_classes/model#transformers.PreTrainedModel). راجع توثيق الفئة الأصلية لمعرفة الطرق العامة التي تنفذها المكتبة لجميع نماذجها (مثل التنزيل أو الحفظ، وتغيير حجم تضمينات الإدخال، وقص الرؤوس، وما إلى ذلك).
هذا النموذج هو أيضاً فئة فرعية من [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) في PyTorch. استخدمه كوحدة PyTorch عادية، وارجع إلى توثيق PyTorch لكل ما يتعلق بالاستخدام العام والسلوك.
#### forward[[transformers.ViltForTokenClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[المصدر](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vilt/modeling_vilt.py#L1207)
**المعاملات:**
input_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز تسلسل الإدخال في قاموس الكلمات. سيتم تجاهل الحشو افتراضيًا. يمكن الحصول على الفهارس باستخدام [AutoTokenizer](/docs/transformers/v5.23.0/ar/model_doc/auto#transformers.AutoTokenizer). راجع [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) و [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ar/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) للتفاصيل. [ما هي معرّفات الإدخال؟](../glossary#input-ids)
attention_mask (`torch.Tensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على فهارس رموز الحشو. قيم القناع المختارة من `[0, 1]`: - 1 للرموز التي **ليست مقنّعة**، - 0 للرموز التي **مقنّعة**. [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` من الشكل `(batch_size, sequence_length)`، *اختياري*) : فهارس رموز المقاطع لتحديد الجزء الأول والثاني من المدخلات. يتم اختيار الفهارس من `[0, 1]`: - 0 يقابل رمز *الجملة أ*، - 1 يقابل رمز *الجملة ب*. [ما هي معرّفات أنواع الرموز؟](../glossary#token-type-ids)
pixel_values (`torch.Tensor` من الشكل `(batch_size, num_channels, image_size, image_size)`، *اختياري*) : المصفوفات المقابلة لصور الإدخال. يمكن الحصول على قيم البكسل باستخدام [ViltImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltImageProcessor). راجع [ViltImageProcessor.__call__()](/docs/transformers/v5.23.0/ar/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) للتفاصيل ([ViltProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltProcessor) يستخدم [ViltImageProcessor](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltImageProcessor) لمعالجة الصور).
pixel_mask (`torch.LongTensor` من الشكل `(batch_size, height, width)`، *اختياري*) : قناع لتجنب تنفيذ الانتباه على قيم البكسلات المعبأة. قيم القناع المختارة في `[0, 1]`: - 1 للبكسلات الحقيقية (أي **غير المقنّعة**)، - 0 للبكسلات المعبأة (أي **المقنّعة**). [ما هي أقنعة الانتباه؟](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` من الشكل `(batch_size, sequence_length, hidden_size)`، *اختياري*) : بدلاً من تمرير `input_ids`، يمكنك اختيار تمرير تمثيل مضمّن مباشرةً. هذا مفيد إذا كنت ترغب في الحصول على مزيد من التحكم في كيفية تحويل فهارس `input_ids` إلى المتجهات المرتبطة بها، مقارنةً بمصفوفة البحث المضمّنة الداخلية للنموذج.
image_embeds (`torch.Tensor` بأبعاد `(batch_size, num_patches, hidden_size)`، *اختياري*) : اختياريًا، بدلاً من تمرير `pixel_values`، يمكنك اختيار تمرير تمثيل مضمّن مباشرة. يكون هذا مفيدًا إذا أردت مزيدًا من التحكم في كيفية تحويل `pixel_values` إلى تضمينات البقع.
labels (`torch.LongTensor` من الشكل `(batch_size, text_sequence_length)`، *اختياري*) : تسميات لحساب خسارة تصنيف الرموز. يجب أن تكون الفهارس ضمن `[0, ..., config.num_labels - 1]`.
output_attentions (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع مصفوفات الانتباه لجميع طبقات الانتباه. راجع `attentions` ضمن المصفوفات المُرجعة لمزيد من التفاصيل.
output_hidden_states (`bool`, *اختياري*) : ما إذا كان سيتم إرجاع الحالات المخفية لجميع الطبقات. راجع `hidden_states` ضمن الموترات المُرجعة لمزيد من التفاصيل.
return_dict (`bool`، *اختياري*) : ما إذا كان سيتم إرجاع [ModelOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.utils.ModelOutput) بدلاً من tuple عادي.
**يعيد:** [TokenClassifierOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) أو `tuple(torch.Tensor)`
[TokenClassifierOutput](/docs/transformers/v5.23.0/ar/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) أو مجموعة مرتبة من `torch.Tensor` (في حال تم تمرير `return_dict=False` أو عندما يكون `config.return_dict=False`) وتتضمن عناصر مختلفة اعتماداً على الإعداد ([ViltConfig](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltConfig)) والمدخلات.
تتجاوز طريقة [ViltForTokenClassification](/docs/transformers/v5.23.0/ar/model_doc/vilt#transformers.ViltForTokenClassification) الخاصة بالتقديم (forward) الطريقة الخاصة `__call__`.
على الرغم من أنه يجب تعريف وصفة المرور الأمامي داخل هذه الدالة، إلا أنه ينبغي استدعاء كائن `Module` بدلاً من هذه الدالة، لأن الكائن يتولى تنفيذ خطوات المعالجة المسبقة والمعالجة اللاحقة، بينما تتجاهل الدالة هذه الخطوات بصمت.
- **loss** (`torch.Tensor` of shape `(1,)`, *اختياري*, يُعاد عند توفير `labels`) -- خسارة التصنيف.
- **logits** (`torch.Tensor` من الشكل `(batch_size, sequence_length, config.num_labels)`) -- درجات التصنيف (قبل SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_hidden_states=True` أو عند تعيين `config.output_hidden_states=True`) -- مجموعة من `torch.Tensor` (واحدة لمخرجات التضمينات، إذا كان النموذج يحتوي على طبقة تضمين، + واحدة لمخرجات كل طبقة) بأبعاد `(batch_size, sequence_length, hidden_size)`.
حالات النموذج المخفية عند مخرج كل طبقة بالإضافة إلى مخرجات التضمين الأولي الاختيارية.
- **attentions** (`tuple(torch.Tensor)`، *اختياري*، يُعاد عند تمرير `output_attentions=True` أو عند تعيين `config.output_attentions=True`) -- مجموعة من `torch.Tensor` (واحدة لكل طبقة) بأبعاد `(batch_size, num_heads, sequence_length, sequence_length)`.
أوزان الانتباه بعد تطبيق دالة softmax على الانتباه، وتُستخدم لحساب المتوسط الموزون في رؤوس الانتباه الذاتي.
مثال:
```python
>>> from transformers import AutoTokenizer, ViltForTokenClassification
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("dandelin/vilt-b32-mlm")
>>> model = ViltForTokenClassification.from_pretrained("dandelin/vilt-b32-mlm")
>>> inputs = tokenizer(
... "HuggingFace is a company based in Paris and New York", add_special_tokens=False, return_tensors="pt"
... )
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_token_class_ids = logits.argmax(-1)
>>> # Note that tokens are classified rather then input words which means that
>>> # there might be more predicted token classes than words.
>>> # Multiple token classes might account for the same word
>>> predicted_tokens_classes = [model.config.id2label[t.item()] for t in predicted_token_class_ids[0]]
>>> predicted_tokens_classes
...
>>> labels = predicted_token_class_ids
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
```