# BridgeTower
## Resumen
El modelo BridgeTower se propuso en [BridgeTower: Building Bridges Between Encoders in Vision-Language Representative Learning](https://huggingface.co/papers/2206.08657) de Xiao Xu, Chenfei Wu, Shachar Rosenman, Vasudev Lal, Wanxiang Che y Nan Duan. El objetivo de este modelo es construir un puente entre cada codificador unimodal y el codificador multimodal para permitir una interacción exhaustiva y detallada en cada capa del codificador multimodal, logrando así un rendimiento notable en diversas tareas de nivel inferior con costos adicionales de rendimiento y computación casi insignificantes.
Este artículo ha sido aceptado en la conferencia [AAAI'23](https://aaai.org/Conferences/AAAI-23/).
El resumen del artículo es el siguiente:
*Los modelos de visión-lenguaje (VL) con arquitectura TWO-TOWER han dominado el aprendizaje de representaciones visuales y lingüísticas en los últimos años. Los modelos VL actuales utilizan codificadores unimodales ligeros y aprenden a extraer, alinear y fusionar ambas modalidades simultáneamente en un codificador cruzado profundo, o bien alimentan las representaciones unimodales de la última capa de los codificadores unimodales preentrenados profundos al codificador cruzado superior. Ambos enfoques pueden restringir el aprendizaje de representaciones de visión-lenguaje y limitar el rendimiento del modelo. En este artículo, proponemos BRIDGETOWER, que introduce múltiples capas de puente que establecen una conexión entre las capas superiores de los codificadores unimodales y cada capa del codificador cruzado. Esto permite una alineación y fusión cruzada efectiva de abajo hacia arriba entre las representaciones visuales y textuales de diferentes niveles semánticos de los codificadores unimodales preentrenados dentro del codificador cruzado. Preentrenado con solo 4M de imágenes, BRIDGETOWER logra un rendimiento líder en diversas tareas descendentes de visión-lenguaje. En particular, en el conjunto test-std de VQAv2, BRIDGETOWER alcanza una precisión del 78,73 %, superando al modelo líder anterior, METER, en un 1,09 % con los mismos datos de preentrenamiento y con parámetros y costes computacionales adicionales casi despreciables. Cabe destacar que, al escalar aún más el modelo, BRIDGETOWER alcanza una precisión del 81,15 %, superando a modelos preentrenados en conjuntos de datos de órdenes de magnitud mayores.*
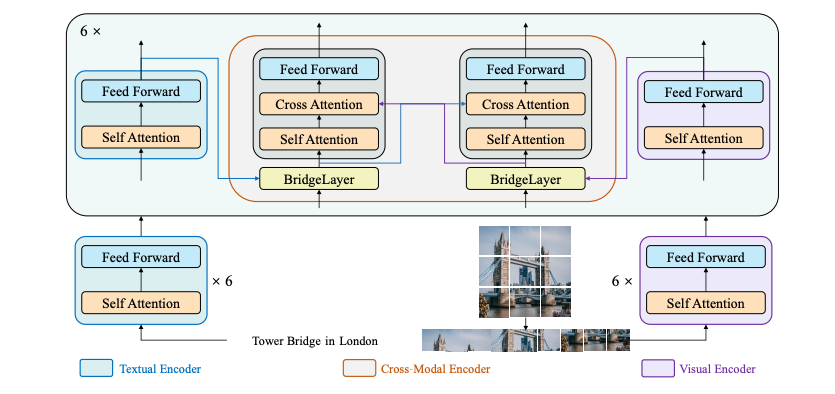 Arquitectura de BridgeTower. Tomada del artículo original.
Este modelo fue aportado por [Anahita Bhiwandiwalla](https://huggingface.co/anahita-b), [Tiep Le](https://huggingface.co/Tile) y [Shaoyen Tseng](https://huggingface.co/shaoyent). El código original se puede encontrar [aquí](https://github.com/microsoft/BridgeTower).
## Consejos de uso y ejemplos
BridgeTower consta de un codificador visual, un codificador textual y un codificador multimodal con múltiples capas de puente ligeras. El objetivo de este enfoque era construir un puente entre cada codificador unimodal y el codificador multimodal para permitir una interacción exhaustiva y detallada en cada capa del codificador multimodal. En principio, se puede aplicar cualquier codificador visual, textual o multimodal en la arquitectura propuesta.
[BridgeTowerProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerProcessor) encapsula [RobertaTokenizer](/docs/transformers/main/es/model_doc/led#transformers.RobertaTokenizer) y [BridgeTowerImageProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) en una única instancia para codificar el texto y preparar las imágenes, respectivamente.
El siguiente ejemplo muestra cómo ejecutar el aprendizaje contrastivo usando [BridgeTowerProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerProcessor) y [BridgeTowerForContrastiveLearning](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerForContrastiveLearning).
```python
import requests
from PIL import Image
from transformers import BridgeTowerForContrastiveLearning, BridgeTowerProcessor
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
model = BridgeTowerForContrastiveLearning.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc", device_map="auto")
# forward pass
scores = dict()
for text in texts:
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
outputs = model(**encoding)
scores[text] = outputs
```
El siguiente ejemplo muestra cómo ejecutar la recuperación de imagen-texto usando [BridgeTowerProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerProcessor) y [BridgeTowerForImageAndTextRetrieval](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerForImageAndTextRetrieval).
```python
import requests
from PIL import Image
from transformers import BridgeTowerForImageAndTextRetrieval, BridgeTowerProcessor
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm", device_map="auto")
# forward pass
scores = dict()
for text in texts:
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
outputs = model(**encoding)
scores[text] = outputs.logits[0, 1].item()
```
El siguiente ejemplo muestra cómo ejecutar el modelado de lenguaje enmascarado usando [BridgeTowerProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerProcessor) y [BridgeTowerForMaskedLM](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerForMaskedLM).
```python
from transformers import BridgeTowerProcessor, BridgeTowerForMaskedLM
from PIL import Image
import requests
url = "http://images.cocodataset.org/val2017/000000360943.jpg"
image = Image.open(requests.get(url, stream=True).raw).convert("RGB")
text = "a looking out of the window"
processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
model = BridgeTowerForMaskedLM.from_pretrained("BridgeTower/bridgetower-base-itm-mlm", device_map="auto")
# prepare inputs
encoding = processor(image, text, return_tensors="pt").to(model.device)
# forward pass
outputs = model(**encoding)
results = processor.decode(outputs.logits.argmax(dim=-1).squeeze(0).tolist())
print(results)
.a cat looking out of the window.
```
Consejos:
- Esta implementación de BridgeTower utiliza [RobertaTokenizer](/docs/transformers/main/es/model_doc/led#transformers.RobertaTokenizer) para generar embeddings de texto y el modelo CLIP/ViT de OpenAI para calcular embeddings visuales.
- Se han publicado los puntos de control para el [bridgeTower-base](https://huggingface.co/BridgeTower/bridgetower-base) preentrenado y para el [modelado de lenguaje enmascarado y la coincidencia de texto e imagen de bridgetower](https://huggingface.co/BridgeTower/bridgetower-base-itm-mlm).
- Consulte la [Tabla 5](https://huggingface.co/papers/2206.08657) para conocer el rendimiento de BridgeTower en la recuperación de imágenes y otras tareas de nivel inferior.
## BridgeTowerConfig[[transformers.BridgeTowerConfig]]
#### transformers.BridgeTowerConfig[[transformers.BridgeTowerConfig]]
```python
transformers.BridgeTowerConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, share_cross_modal_transformer_layers: bool = True, hidden_act: str = 'gelu', hidden_size: int = 768, initializer_factor: float | int = 1, layer_norm_eps: float = 1e-05, share_link_tower_layers: bool = False, link_tower_type: str = 'add', num_attention_heads: int = 12, num_hidden_layers: int = 6, tie_word_embeddings: bool = False, init_layernorm_from_vision_encoder: bool = False, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/configuration_bridgetower.py#L104)
**Parámetros:**
share_cross_modal_transformer_layers (`bool`, *opcional*, valor predeterminado `True`) : Indica si las capas del transformer multimodal se comparten.
hidden_act (`str`, *opcional*, valor predeterminado `gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_size (`int`, *opcional*, valor predeterminado `768`) : Dimensión de las representaciones ocultas.
initializer_factor (`Union[float, int]`, *opcional*, valor predeterminado `1`) : Un factor para inicializar todas las matrices de pesos (debe mantenerse en 1, se usa internamente para pruebas de inicialización).
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-05`) : El epsilon utilizado por las capas de normalización de capas.
share_link_tower_layers (`bool`, *opcional*, valor predeterminado `False`) : Indica si las capas del puente/torre de enlace se comparten.
link_tower_type (`str`, *opcional*, valor predeterminado `"add"`) : Tipo de la capa de enlace/puente.
num_attention_heads (`int`, *opcional*, valor predeterminado `12`) : Número de cabezas de atención para cada capa de atención en el decodificador Transformer.
num_hidden_layers (`int`, *opcional*, valor predeterminado `6`) : Número de capas ocultas en el decodificador del Transformer.
tie_word_embeddings (`bool`, *opcional*, valor predeterminado `False`) : Si se deben vincular las incrustaciones de pesos según el mapeo `tied_weights_keys` del modelo.
init_layernorm_from_vision_encoder (`bool`, *opcional*, valor predeterminado `False`) : Si se debe inicializar LayerNorm desde el codificador de visión.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : El objeto de configuración o el diccionario del backbone de texto.
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : El objeto de configuración o el diccionario del backbone de visión.
Esta es la clase de configuración para almacenar la configuración de un BridgeTowerModel. Se utiliza para instanciar un modelo Bridgetower según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/main/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/main/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import BridgeTowerModel, BridgeTowerConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration
>>> configuration = BridgeTowerConfig()
>>> # Initializing a model from the BridgeTower/bridgetower-base style configuration
>>> model = BridgeTowerModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## BridgeTowerTextConfig[[transformers.BridgeTowerTextConfig]]
#### transformers.BridgeTowerTextConfig[[transformers.BridgeTowerTextConfig]]
```python
transformers.BridgeTowerTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 50265, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, initializer_factor: float | int = 1, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 514, type_vocab_size: int = 1, layer_norm_eps: float = 1e-05, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, use_cache: bool = True, is_decoder: bool = False, add_cross_attention: bool = False)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/configuration_bridgetower.py#L65)
**Parámetros:**
vocab_size (`int`, *opcional*, valor predeterminado `50265`) : Tamaño del vocabulario del modelo. Define el número de tokens diferentes que pueden representarse mediante `input_ids`.
hidden_size (`int`, *opcional*, valor predeterminado `768`) : Dimensión de las representaciones ocultas.
num_hidden_layers (`int`, *opcional*, valor predeterminado `12`) : Número de capas ocultas en el decodificador del Transformer.
num_attention_heads (`int`, *opcional*, valor predeterminado `12`) : Número de cabezas de atención para cada capa de atención en el decodificador Transformer.
initializer_factor (`Union[float, int]`, *opcional*, valor predeterminado `1`) : Un factor para inicializar todas las matrices de pesos (debe mantenerse en 1, se usa internamente para pruebas de inicialización).
intermediate_size (`int`, *opcional*, valor predeterminado `3072`) : Dimensión de las representaciones MLP.
hidden_act (`str`, *opcional*, valor predeterminado `gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *opcional*, valor predeterminado `0.1`) : La probabilidad de dropout para todas las capas totalmente conectadas en los embeddings, el codificador y el pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, valor predeterminado `0.1`) : La proporción de dropout para las probabilidades de atención.
max_position_embeddings (`int`, *opcional*, valor predeterminado `514`) : La longitud máxima de secuencia con la que se podría utilizar este modelo.
type_vocab_size (`int`, *opcional*, valor predeterminado `1`) : El tamaño del vocabulario de `token_type_ids`.
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-05`) : El epsilon utilizado por las capas de normalización de capas.
pad_token_id (`int`, *opcional*, valor predeterminado `1`) : Id de token utilizado para el relleno en el vocabulario.
bos_token_id (`int`, *opcional*, valor predeterminado `0`) : Id de token utilizado para el inicio de la secuencia en el vocabulario.
eos_token_id (`Union[int, list[int]]`, *opcional*, valor predeterminado `2`) : Identificador de token utilizado para el fin de la secuencia en el vocabulario.
use_cache (`bool`, *opcional*, valor predeterminado `True`) : Indica si el modelo debe devolver las últimas atenciones de claves/valores (no se utiliza en todos los modelos). Solo es relevante si `config.is_decoder=True` o cuando el modelo es un modelo generativo solo de decodificador.
is_decoder (`bool`, *opcional*, valor predeterminado `False`) : Indica si el modelo se utiliza como decodificador. Si es `False`, el modelo se utiliza como codificador.
add_cross_attention (`bool`, *opcional*, valor predeterminado `False`) : Si se deben añadir capas de atención cruzada al modelo.
Esta es la clase de configuración para almacenar la configuración de un BridgeTowerModel. Se utiliza para instanciar un modelo Bridgetower según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/main/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/main/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import BridgeTowerTextConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration for the text model
>>> configuration = BridgeTowerTextConfig()
>>> # Accessing the configuration
>>> configuration
```
## BridgeTowerVisionConfig[[transformers.BridgeTowerVisionConfig]]
#### transformers.BridgeTowerVisionConfig[[transformers.BridgeTowerVisionConfig]]
```python
transformers.BridgeTowerVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_channels: int = 3, patch_size: int | list[int] | tuple[int, int] = 16, image_size: int | list[int] | tuple[int, int] = 288, initializer_factor: float | int = 1, layer_norm_eps: float = 1e-05, stop_gradient: bool = False, share_layernorm: bool = True, remove_last_layer: bool = False)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/configuration_bridgetower.py#L27)
**Parámetros:**
hidden_size (`int`, *opcional*, valor predeterminado `768`) : Dimensión de las representaciones ocultas.
num_hidden_layers (`int`, *opcional*, valor predeterminado `12`) : Número de capas ocultas en el decodificador del Transformer.
num_channels (`int`, *opcional*, valor predeterminado `3`) : El número de canales de entrada.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `16`) : El tamaño (resolución) de cada parche.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `288`) : El tamaño (resolución) de cada imagen.
initializer_factor (`Union[float, int]`, *opcional*, valor predeterminado `1`) : Un factor para inicializar todas las matrices de pesos (debe mantenerse en 1, se usa internamente para pruebas de inicialización).
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-05`) : El epsilon utilizado por las capas de normalización de capas.
stop_gradient (`bool`, *opcional*, valor predeterminado `False`) : Si se debe detener el gradiente para el entrenamiento.
share_layernorm (`bool`, *opcional*, por defecto `True`) : Indica si las capas LayerNorm se comparten.
remove_last_layer (`bool`, *opcional*, valor predeterminado `False`) : Indica si se debe eliminar la última capa del codificador de visión.
Esta es la clase de configuración para almacenar la configuración de un BridgeTowerModel. Se utiliza para instanciar un modelo Bridgetower según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [BridgeTower/bridgetower-base](https://huggingface.co/BridgeTower/bridgetower-base)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/main/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/main/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import BridgeTowerVisionConfig
>>> # Initializing a BridgeTower BridgeTower/bridgetower-base style configuration for the vision model
>>> configuration = BridgeTowerVisionConfig()
>>> # Accessing the configuration
>>> configuration
```
## BridgeTowerImageProcessor[[transformers.BridgeTowerImageProcessor]]
#### transformers.BridgeTowerImageProcessor[[transformers.BridgeTowerImageProcessor]]
```python
transformers.BridgeTowerImageProcessor(**kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/image_processing_bridgetower.py#L76)
**Parámetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'shortest_edge' : 288}`): Describe las dimensiones máximas de entrada para el modelo.
default_to_square (`bool`, *kwargs*, *opcional*, valor predeterminado `False`) : Si se debe usar una imagen cuadrada por defecto al redimensionar, cuando size es un int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'shortest_edge' : 288}`): Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, por defecto `3`) : Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*, valor predeterminado `0.00392156862745098`) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.48145466, 0.4578275, 0.40821073]`) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.26862954, 0.26130258, 0.27577711]`) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` se establece en `True`.
do_pad (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el mayor tamaño del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
size_divisor (`int`, *kwargs*, por defecto `32`) : El tamaño con el que se asegura que tanto la altura como el ancho sean divisibles.
Construye un procesador de imágenes BridgeTowerImageProcessor.
#### preprocess[[transformers.BridgeTowerImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Bandera para desarrolladores destinada a entradas adicionales similares a imágenes que también se preprocesarán. Utilice esto solo si pasar las entradas como kwarg no funciona. Por ejemplo, `preprocess(images, masks=masks)` es la opción preferida, pero puede provocar problemas de prioridad de argumentos en algunos modelos. En esos casos, se puede usar `preprocess(images, image_like_inputs={"masks": masks})` en su lugar.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Si el tamaño es un entero, si se debe usar una imagen cuadrada por defecto al redimensionar.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
**Devuelve:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Diccionario de listas/arrays/tensores devueltos por el método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
Preprocesa una imagen o un lote de imágenes.
## BridgeTowerImageProcessorPil[[transformers.BridgeTowerImageProcessorPil]]
#### transformers.BridgeTowerImageProcessorPil[[transformers.BridgeTowerImageProcessorPil]]
```python
transformers.BridgeTowerImageProcessorPil(**kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/image_processing_pil_bridgetower.py#L70)
**Parámetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'shortest_edge' : 288}`): Describe las dimensiones máximas de entrada para el modelo.
default_to_square (`bool`, *kwargs*, *opcional*, valor predeterminado `False`) : Si se debe usar una imagen cuadrada por defecto al redimensionar, cuando size es un int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'shortest_edge' : 288}`): Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, por defecto `3`) : Filtro de remuestreo a utilizar si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*, valor predeterminado `0.00392156862745098`) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.48145466, 0.4578275, 0.40821073]`) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.26862954, 0.26130258, 0.27577711]`) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` se establece en `True`.
do_pad (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el mayor tamaño del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
size_divisor (`int`, *kwargs*, por defecto `32`) : El tamaño con el que se asegura que tanto la altura como el ancho sean divisibles.
Construye un procesador de imágenes BridgeTowerImageProcessor.
#### preprocess[[transformers.BridgeTowerImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/image_processing_utils.py#L382)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *opcional*) : Bandera para desarrolladores destinada a entradas adicionales similares a imágenes que también se preprocesarán. Utilice esto solo si pasar las entradas como kwarg no funciona. Por ejemplo, `preprocess(images, masks=masks)` es la opción preferida, pero puede provocar problemas de prioridad de argumentos en algunos modelos. En esos casos, se puede usar `preprocess(images, image_like_inputs={"masks": masks})` en su lugar.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Si el tamaño es un entero, si se debe usar una imagen cuadrada por defecto al redimensionar.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
**Devuelve:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Diccionario de listas/arrays/tensores devueltos por el método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
Preprocesa una imagen o un lote de imágenes.
## BridgeTowerProcessor[[transformers.BridgeTowerProcessor]]
#### transformers.BridgeTowerProcessor[[transformers.BridgeTowerProcessor]]
```python
transformers.BridgeTowerProcessor(image_processor, tokenizer)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/processing_bridgetower.py#L42)
**Parámetros:**
image_processor (`BridgeTowerImageProcessor`) : El procesador de imágenes es un parámetro de entrada obligatorio.
tokenizer (`RobertaTokenizer`) : El tokenizador es una entrada obligatoria.
Construye un BridgeTowerProcessor que envuelve un procesador de imágenes y un tokenizador en un único procesador.
[BridgeTowerProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerProcessor) ofrece todas las funcionalidades de [BridgeTowerImageProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) y [RobertaTokenizer](/docs/transformers/main/es/model_doc/led#transformers.RobertaTokenizer). Consulte [~BridgeTowerImageProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) y [~RobertaTokenizer](/docs/transformers/main/es/model_doc/led#transformers.RobertaTokenizer) para obtener más información.
#### __llamada__[[transformers.BridgeTowerProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/processing_utils.py#L659)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opcional*) : Imagen para preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opcional*) : La secuencia o el lote de secuencias que se van a codificar. Cada secuencia puede ser una cadena de caracteres o una lista de cadenas (cadena pretokenizada). Si se pasa una entrada pretokenizada, establezca `is_split_into_words=True` para evitar ambigüedad con las entradas en lote.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *opcional*) : Video a preprocesar. Se espera un único video o un lote de videos con valores de píxeles que van de 0 a 255. Si se pasan videos con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *opcional*) : El audio o lote de audios que se va a preparar. Cada audio puede ser un array de NumPy o un tensor de PyTorch. En el caso de un array de NumPy/tensor de PyTorch, cada audio debe tener la forma (C, T), donde C es el número de canales y T es la longitud de muestreo del audio.
return_tensors (`str` o [TensorType](/docs/transformers/main/es/internal/file_utils#transformers.TensorType), *opcional*) : Si se establece, devolverá tensores de un marco de trabajo específico. Los valores aceptables son: - `'pt'`: Devuelve objetos `torch.Tensor` de PyTorch. - `'np'`: Devuelve objetos `np.ndarray` de NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/es/main_classes/processors#transformers.ProcessingKwargs), *opcional*) : Opciones de procesamiento adicionales para cada modalidad (texto, imágenes, vídeos, audio). Los parámetros específicos del modelo se enumeran arriba; consulte la clase TypedDict para obtener la lista completa de argumentos admitidos.
## BridgeTowerModel[[transformers.BridgeTowerModel]]
#### transformers.BridgeTowerModel[[transformers.BridgeTowerModel]]
```python
transformers.BridgeTowerModel(config: BridgeTowerConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1079)
**Parámetros:**
config ([BridgeTowerConfig](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo BridgeTower Model básico que devuelve un objeto BridgeTowerModelOutput sin ninguna cabeza específica
Este modelo hereda de [PreTrainedModel](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.BridgeTowerModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, image_token_type_idx: int | None = None, labels: typing.Optional[torch.LongTensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1152)
**Parámetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/main/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [BridgeTowerImageProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Consulte [BridgeTowerImageProcessor.__call__()](/docs/transformers/main/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles ([BridgeTowerProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerProcessor) utiliza [BridgeTowerImageProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) para procesar imágenes).
pixel_mask (`torch.LongTensor` de forma `(batch_size, height, width)`, *opcional*) : Máscara para evitar realizar atención sobre los valores de píxeles de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para píxeles reales (es decir, **no enmascarados**), - 0 para píxeles de relleno (es decir, **enmascarados**). [¿Qué son las máscaras de atención?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
image_embeds (`torch.Tensor` de forma `(batch_size, num_patches, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `pixel_values`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir `pixel_values` en incrustaciones de parches.
image_token_type_idx (`int`, *opcional*) : - Los ids de tipo de token para las imágenes.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Las etiquetas no se admiten actualmente.
interpolate_pos_encoding (`bool`, *opcional*, valor predeterminado `False`) : Si se debe interpolar las codificaciones de posición preentrenadas.
**Devuelve:** `BridgeTowerModelOutput` o `tuple(torch.Tensor)`
Un `BridgeTowerModelOutput` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([BridgeTowerConfig](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerConfig)) y las entradas.
El método forward de [BridgeTowerModel](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerModel) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **text_features** (`torch.Tensor` de forma `(batch_size, text_sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de texto de la última capa del modelo.
- **image_features** (`torch.Tensor` de forma `(batch_size, image_sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de imagen de la última capa del modelo.
- **pooler_output** (`torch.Tensor` de forma `(batch_size, hidden_size x 2)`) -- Concatenación del estado oculto de la última capa del primer token de la secuencia de texto y de la secuencia de imagen (token de clasificación), respectivamente, después de un procesamiento adicional a través de las capas utilizadas para tareas de preentrenamiento auxiliares.
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> # prepare image and text
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "hello world"
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base")
>>> model = BridgeTowerModel.from_pretrained("BridgeTower/bridgetower-base")
>>> inputs = processor(image, text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> outputs.keys()
odict_keys(['text_features', 'image_features', 'pooler_output'])
```
## BridgeTowerForContrastiveLearning[[transformers.BridgeTowerForContrastiveLearning]]
#### transformers.BridgeTowerForContrastiveLearning[[transformers.BridgeTowerForContrastiveLearning]]
```python
transformers.BridgeTowerForContrastiveLearning(config: BridgeTowerConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1603)
**Parámetros:**
config ([BridgeTowerConfig](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
Modelo BridgeTower con una cabeza contrastiva de imagen-texto en la parte superior que calcula la pérdida contrastiva de imagen-texto.
Este modelo hereda de [PreTrainedModel](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.BridgeTowerForContrastiveLearning.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, return_loss: bool | None = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1617)
**Parámetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/main/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [BridgeTowerImageProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Consulte [BridgeTowerImageProcessor.__call__()](/docs/transformers/main/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles ([BridgeTowerProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerProcessor) utiliza [BridgeTowerImageProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) para procesar imágenes).
pixel_mask (`torch.LongTensor` de forma `(batch_size, height, width)`, *opcional*) : Máscara para evitar realizar atención sobre los valores de píxeles de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para píxeles reales (es decir, **no enmascarados**), - 0 para píxeles de relleno (es decir, **enmascarados**). [¿Qué son las máscaras de atención?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
image_embeds (`torch.Tensor` de forma `(batch_size, num_patches, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `pixel_values`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir `pixel_values` en incrustaciones de parches.
return_loss (`bool`, *opcional*) : Indica si se debe devolver la pérdida contrastiva.
**Devuelve:** `BridgeTowerContrastiveOutput` o `tuple(torch.Tensor)`
Un `BridgeTowerContrastiveOutput` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([BridgeTowerConfig](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerConfig)) y las entradas.
El método forward de [BridgeTowerForContrastiveLearning](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerForContrastiveLearning) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, devuelto cuando `return_loss` es `True`) -- Pérdida contrastiva de imagen-texto.
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Puntuaciones de predicción de la cabeza de modelado de lenguaje (puntuaciones para cada token del vocabulario antes de SoftMax).
- **text_embeds** (`torch.Tensor)`, *optional*, returned when model is initialized with `with_projection=True`) -- The text embeddings obtained by applying the projection layer to the pooler_output.
- **image_embeds** (`torch.Tensor)`, *optional*, returned when model is initialized with `with_projection=True`) -- The image embeddings obtained by applying the projection layer to the pooler_output.
- **cross_embeds** (`torch.Tensor)`, *optional*, returned when model is initialized with `with_projection=True`) -- The text-image cross-modal embeddings obtained by applying the projection layer to the pooler_output.
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Ejemplos:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForContrastiveLearning
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> image_urls = [
... "https://farm4.staticflickr.com/3395/3428278415_81c3e27f15_z.jpg",
... "http://images.cocodataset.org/val2017/000000039769.jpg",
... ]
>>> texts = ["two dogs in a car", "two cats sleeping on a couch"]
>>> with httpx.stream("GET", urls[0]) as response:
... image1 = Image.open(BytesIO(response.read()))
>>> with httpx.stream("GET", urls[1]) as response:
... image2 = Image.open(BytesIO(response.read()))
>>> images = [image1, image2]
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
>>> model = BridgeTowerForContrastiveLearning.from_pretrained("BridgeTower/bridgetower-large-itm-mlm-itc")
>>> inputs = processor(images, texts, padding=True, return_tensors="pt")
>>> loss = model(**inputs, return_loss=True).loss
>>> inputs = processor(images, texts[::-1], padding=True, return_tensors="pt")
>>> loss_swapped = model(**inputs, return_loss=True).loss
>>> print("Loss", round(loss.item(), 4))
Loss 0.0019
>>> print("Loss with swapped images", round(loss_swapped.item(), 4))
Loss with swapped images 2.126
```
## BridgeTowerForMaskedLM[[transformers.BridgeTowerForMaskedLM]]
#### transformers.BridgeTowerForMaskedLM[[transformers.BridgeTowerForMaskedLM]]
```python
transformers.BridgeTowerForMaskedLM(config: BridgeTowerConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1404)
**Parámetros:**
config ([BridgeTowerConfig](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
Modelo BridgeTower con una cabeza de modelado de lenguaje en la parte superior, tal como se hizo durante el preentrenamiento.
Este modelo hereda de [PreTrainedModel](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.BridgeTowerForMaskedLM.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1422)
**Parámetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/main/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [BridgeTowerImageProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Consulte [BridgeTowerImageProcessor.__call__()](/docs/transformers/main/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles ([BridgeTowerProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerProcessor) utiliza [BridgeTowerImageProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) para procesar imágenes).
pixel_mask (`torch.LongTensor` de forma `(batch_size, height, width)`, *opcional*) : Máscara para evitar realizar atención sobre los valores de píxeles de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para píxeles reales (es decir, **no enmascarados**), - 0 para píxeles de relleno (es decir, **enmascarados**). [¿Qué son las máscaras de atención?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
image_embeds (`torch.Tensor` de forma `(batch_size, num_patches, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `pixel_values`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir `pixel_values` en incrustaciones de parches.
labels (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Etiquetas para calcular la pérdida de modelado de lenguaje enmascarado. Los índices deben estar en `[-100, 0, ..., config.vocab_size]` (ver la docstring de `input_ids`). Los tokens con índices establecidos en `-100` se ignoran (se enmascaran); la pérdida solo se calcula para los tokens con etiquetas en `[0, ..., config.vocab_size]`.
**Devuelve:** [MaskedLMOutput](/docs/transformers/main/es/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) o `tuple(torch.Tensor)`
Un [MaskedLMOutput](/docs/transformers/main/es/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([BridgeTowerConfig](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerConfig)) y las entradas.
El método forward de [BridgeTowerForMaskedLM](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerForMaskedLM) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, se devuelve cuando se proporciona `labels`) -- Pérdida de modelado de lenguaje enmascarado (MLM).
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Puntuaciones de predicción de la cabeza de modelado de lenguaje (puntuaciones para cada token del vocabulario antes de SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForMaskedLM
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000360943.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> text = "a looking out of the window"
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> model = BridgeTowerForMaskedLM.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> # prepare inputs
>>> encoding = processor(image, text, return_tensors="pt")
>>> # forward pass
>>> outputs = model(**encoding)
>>> results = processor.decode(outputs.logits.argmax(dim=-1).squeeze(0).tolist())
>>> print(results)
.a cat looking out of the window.
```
## BridgeTowerForImageAndTextRetrieval[[transformers.BridgeTowerForImageAndTextRetrieval]]
#### transformers.BridgeTowerForImageAndTextRetrieval[[transformers.BridgeTowerForImageAndTextRetrieval]]
```python
transformers.BridgeTowerForImageAndTextRetrieval(config: BridgeTowerConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1501)
**Parámetros:**
config ([BridgeTowerConfig](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
Modelo transformer de BridgeTower con una cabeza de clasificador en la parte superior (una capa lineal sobre el estado oculto final del token [CLS]) para el emparejamiento de imagen a texto.
Este modelo hereda de [PreTrainedModel](/docs/transformers/main/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.BridgeTowerForImageAndTextRetrieval.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.LongTensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, image_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.LongTensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/main/src/transformers/models/bridgetower/modeling_bridgetower.py#L1512)
**Parámetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/main/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/main/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [BridgeTowerImageProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerImageProcessor). Consulte [BridgeTowerImageProcessor.__call__()](/docs/transformers/main/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para más detalles ([BridgeTowerProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerProcessor) utiliza [BridgeTowerImageProcessor](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerImageProcessor) para procesar imágenes).
pixel_mask (`torch.LongTensor` de forma `(batch_size, height, width)`, *opcional*) : Máscara para evitar realizar atención sobre los valores de píxeles de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para píxeles reales (es decir, **no enmascarados**), - 0 para píxeles de relleno (es decir, **enmascarados**). [¿Qué son las máscaras de atención?](../glossary#attention-mask)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
image_embeds (`torch.Tensor` de forma `(batch_size, num_patches, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `pixel_values`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir `pixel_values` en incrustaciones de parches.
labels (`torch.LongTensor` de forma `(batch_size, 1)`, *opcional*) : Etiquetas para calcular la pérdida de correspondencia entre imagen y texto. 0 significa que las parejas no coinciden y 1 significa que sí. Las parejas con 0 se omitirán en el cálculo.
**Devuelve:** [SequenceClassifierOutput](/docs/transformers/main/es/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) o `tuple(torch.Tensor)`
Un [SequenceClassifierOutput](/docs/transformers/main/es/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([BridgeTowerConfig](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerConfig)) y las entradas.
El método forward de [BridgeTowerForImageAndTextRetrieval](/docs/transformers/main/es/model_doc/bridgetower#transformers.BridgeTowerForImageAndTextRetrieval) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, se devuelve cuando se proporciona `labels`) -- Pérdida de clasificación (o de regresión si config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Puntuaciones de clasificación (o de regresión si config.num_labels==1) (antes de SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> from transformers import BridgeTowerProcessor, BridgeTowerForImageAndTextRetrieval
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> texts = ["An image of two cats chilling on a couch", "A football player scoring a goal"]
>>> processor = BridgeTowerProcessor.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> model = BridgeTowerForImageAndTextRetrieval.from_pretrained("BridgeTower/bridgetower-base-itm-mlm")
>>> # forward pass
>>> scores = dict()
>>> for text in texts:
... # prepare inputs
... encoding = processor(image, text, return_tensors="pt")
... outputs = model(**encoding)
... scores[text] = outputs.logits[0, 1].item()
```